【学习笔记】刘二《PyTorch深度学习实践》- 3
1 卷积神经网络-基础篇
1.1 卷积神经网络学习
我们之前的神经网络,是由多个线性层串行的,这种神经网络叫做全连接神经网络。由于线性层的输入和下一个节点任意一个输出的都有相应的权重,都需要参与到下一个节点任意一个输出的计算,那么这种线性层也叫全连接层。
在使用 Softmax 训练 MNIST 数据集时,将数据输入全连接神经网络前,为了让输入满足线性回归模型的输入要求,做了一个前置操作,就是将 [N, 1, 28, 28] 的这么一个输入,转化为了 [N, 784] 。也就是说,这个前置操作将原有的图片数据的空间信息消除了。
在执行训练代码时,训练的最终结果,模型的准确率位置在 97.5 % 左右。而为什么不能继续升高,其实有一部分原因就是代码消除了图片数据的空间信息。例如这样的一个矩阵:
[
	[1, 2, 3],
	[4, 5, 6],
	[7, 8, 9]
]
将其压缩成一维后:
[1, 2, 3, 4, 5, 6, 7, 8, 9]这就会导致一个问题,在原矩阵中,1 和 4 是一个相邻的元素,而压缩成一维后,却变得不相邻了。也就是说,消除空间信息后,同样了消除元素在空间上的关系。这就可能导致在原来的数据上,这两个像素点是相关的,但输入到模型后,模型认为它们是不相关的,这也是导致准确率上不去的一个原因。
所以,为了位置输入数据在空间上的信息,就给神经网络引入卷积层,这个卷积层用于保存输入数据的空间信息,确保空间信息不会丢失。这种神经网络也称卷积神经网络(CNN)。
卷积神经网络主要分为两个部分,第一个部分是特征提取(Feature Extraction),第二个部分是分类(Classification)。
特征提取部分中,主要存在两个层,一个是卷积层(Convolution),负责做局部的特征检测,用于提取重要特征,过滤冗余特征;另一个是池化层(或者叫下采样,Subsampling),负责降维,对卷积层提取的特征进行压缩。
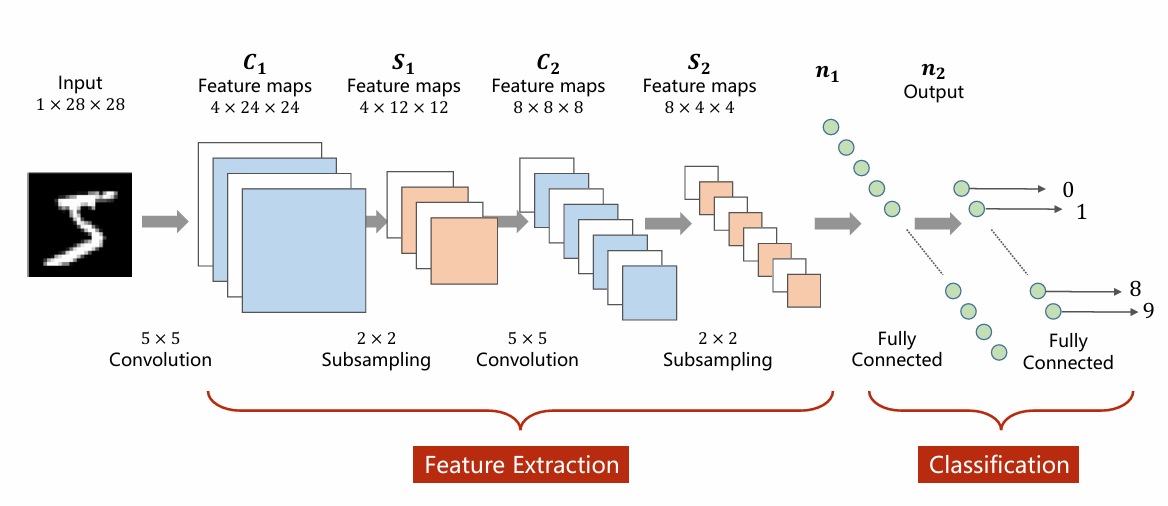
而分类部分,主要是通过全连接层和输出层,将提取到的特征,展平成向量,然后进行综合的加权计算(分类),并给出最终的分类结果。
在模型中,卷积实际上做的是矩阵运算:
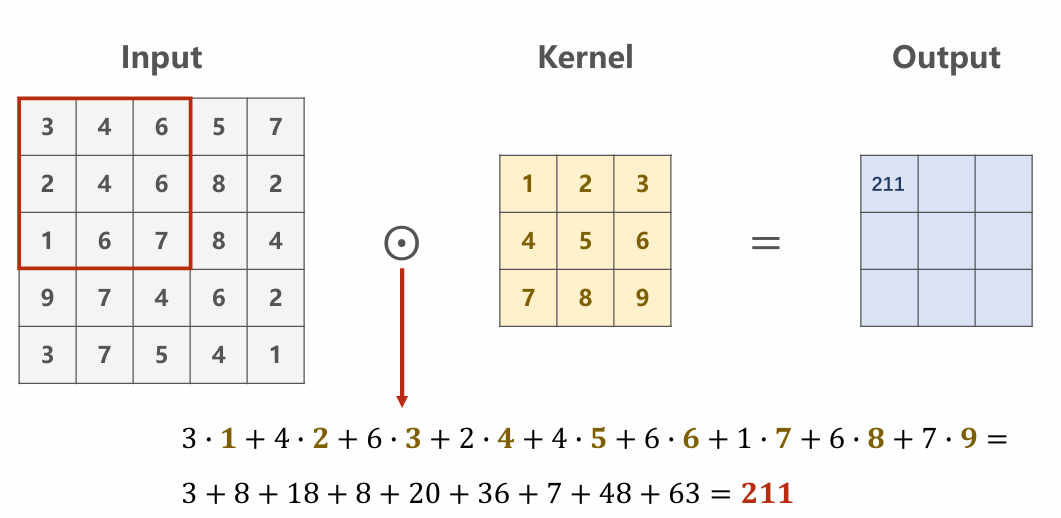
输入是一个矩阵,这个矩阵,需要根据卷积核(Kernel)的大小,依次将相应的子矩阵的元素对卷积核进行数乘运算(对应元素相乘),然后求和,得到输出的矩阵相应位置的结果:
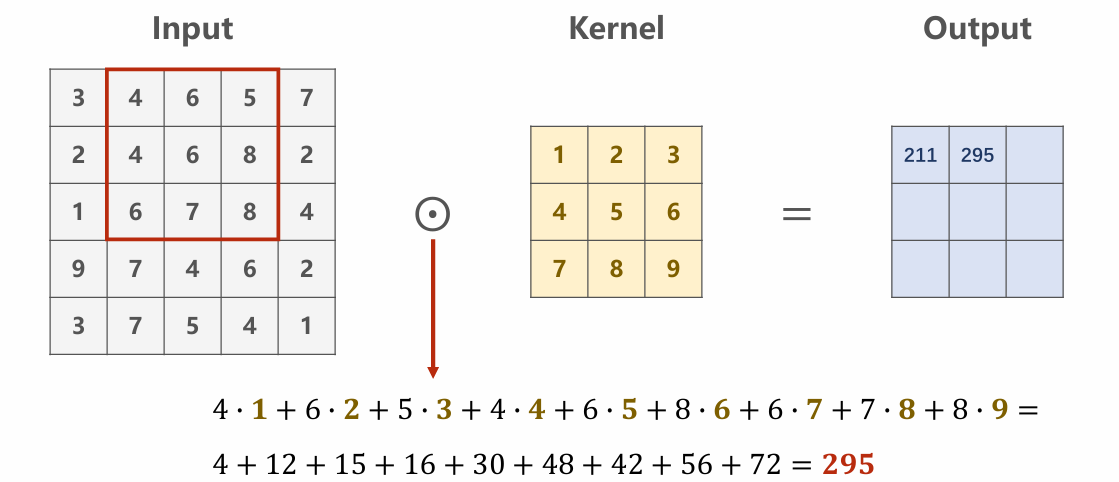
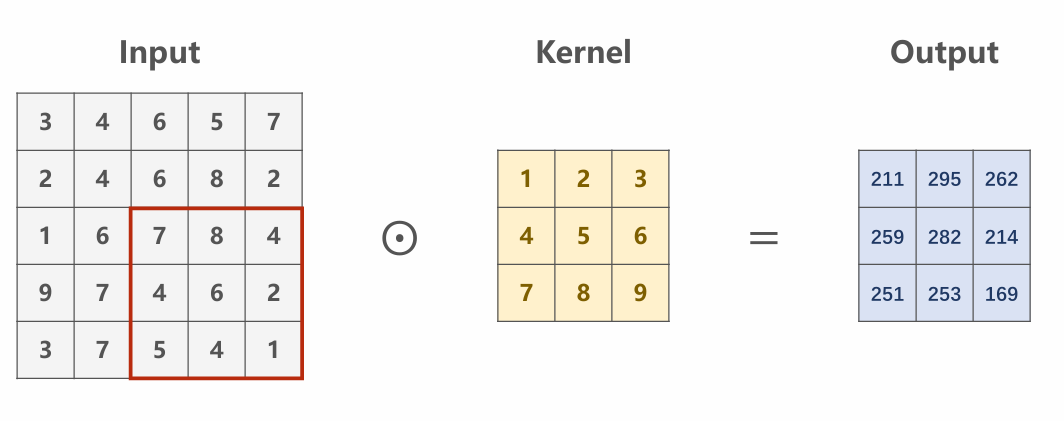
当然,这是对单输入而言,如果是多输入,则需要对每个输入的输出矩阵,做求和运算。
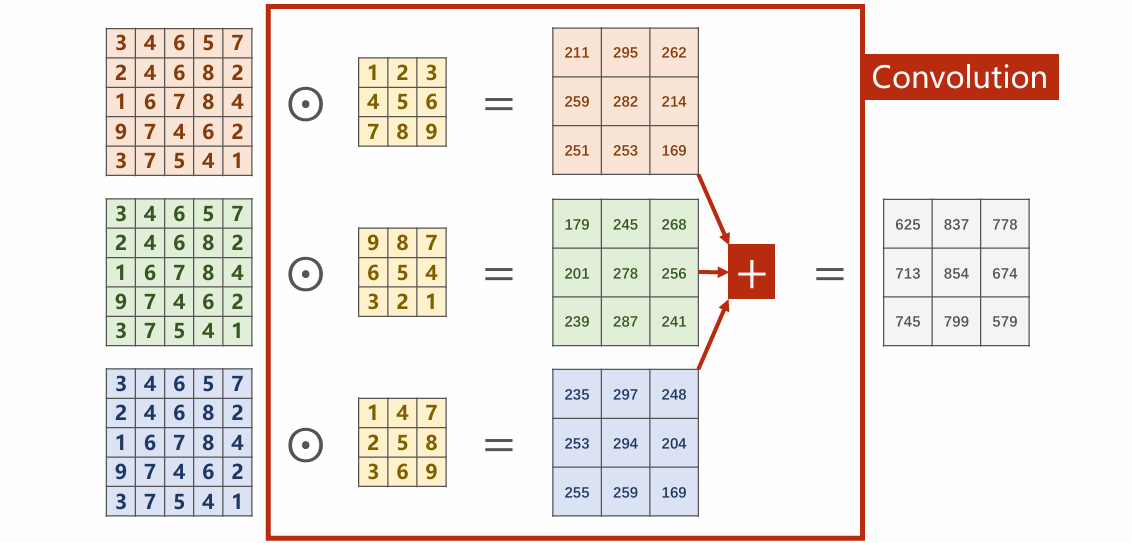
对于多通道输入,输入通道的数量,决定了卷积核的通道数量,卷积核的总个数决定了输出的通道数。每个通道的输入,都对应一个卷积核相应的通道,例如 1 通道就是数乘卷积核的 1 通道、 2 通道就是数乘卷积核的 2 通道。
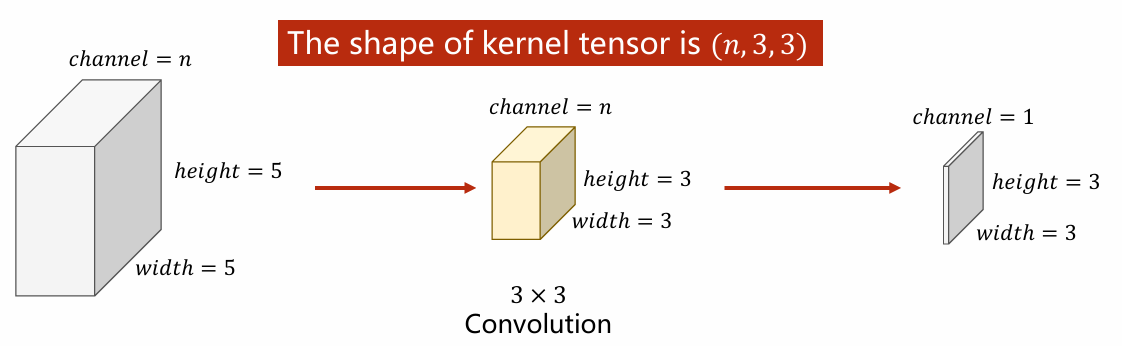
从图中可以看出,3 个通道的输入,变成了 1 个通道的输出。而输出的矩阵宽高,都是 3 。为什么呢,从计算过程也能理解,但是这里有个更加便捷的公式:
其中,y 指的是输出的宽或高, 值得是输出的宽或高, 指的是卷积核的宽或高。用上面的例子简单计算一下:
但有时候我们不希望是单通道的输出,例如我希望彩色图片的输入,也能保留彩色图片的输出。怎么做呢,既然 3 通道的输入,经过一个卷积核,得出 1 通道的输出,那我只要再添加 2 个卷积核,再得出 2 个 1 通道的输出,然后将这 3 个输出合并,就得到 3 个通道的输出:
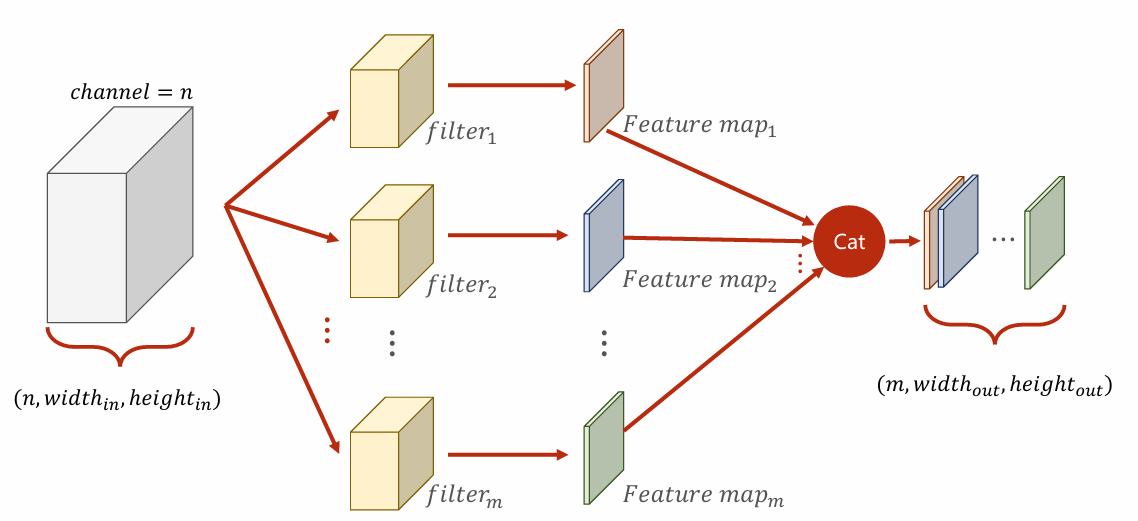
我们上面提出的结论:输入通道的数量,决定了卷积核的通道数量,卷积核的总个数决定了输出的通道数,在这里得到了验证:卷积核的通道数 = 输入的通道数;输出的通道数 = 卷积核的数量。
所以,在我们进行图片数据的卷积计算时,就可以这样确定卷积核:
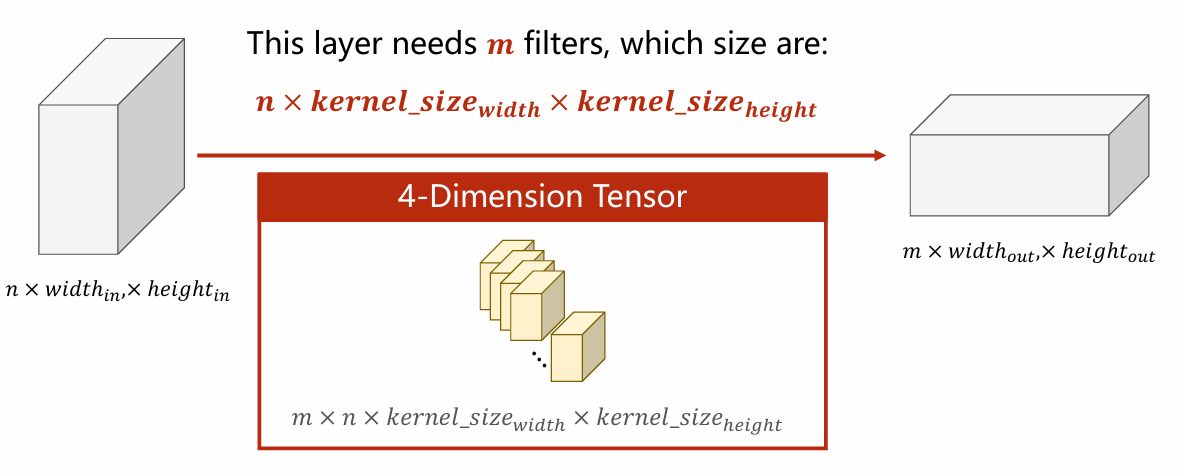
输入是三维: ,输出是三维: ,那么卷积核就是四维的:。也就是 个通道数为 的 的矩阵。
还有一个概念,就是叫共享权重,指的是所有的输出通道都用的同一个卷积核。
在进行卷积时,我们可能还对输出有其他要求,例如我希望输入和输出的宽高是一样的,我希望输出不要是 3 x 3 ,我希望是 2 x 2 的。对于这两个要求,都有相应的处理方法。
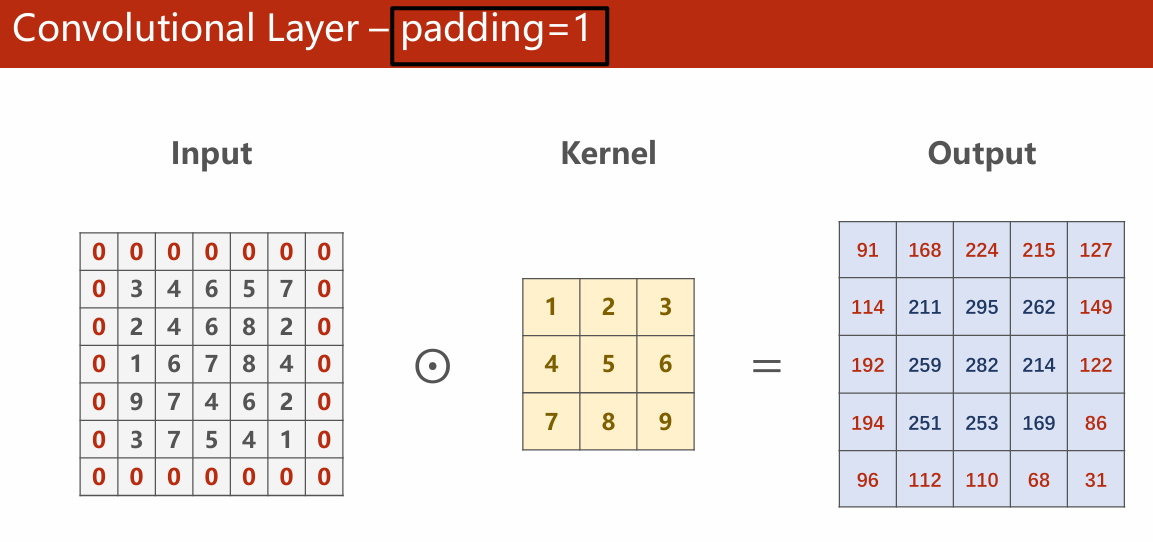
希望输入(5 x 5)和输出(3 x 3)的宽高是一样,也就是希望输出的维度要增加到 5 x 5,我们就可以通过 padding 机制,对输入增加一圈 0 ,也就是上下左右各增加一段 0 向量,使输入变成 7 x 7 ,这样输出就会是 5 x 5 了。
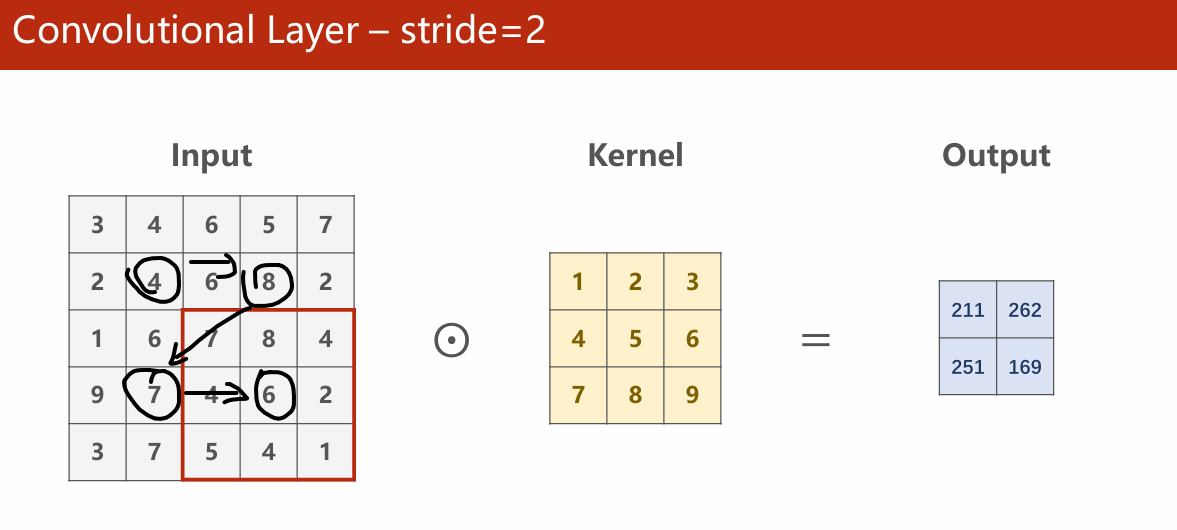
希望输出不要是 3 x 3 ,而是 2 x 2 的,也就是希望输出结果降维。我们可以通过设置 stride 步长,让卷积的每次移动,增加一段距离,使得总共进行 4 次卷积运算,达到降维效果:
接下来就是池化(Pooling),或者说下采样(Subsampling)。通常使用的方法是最大池化(MaxPooling ),例如设置一个 2 x 2 的 MaxPooling,那么它就会对原矩阵按照 2 x 2 的大小划分,并且取出每个 2 x 2 这个区域的最大值,组成新的矩阵。
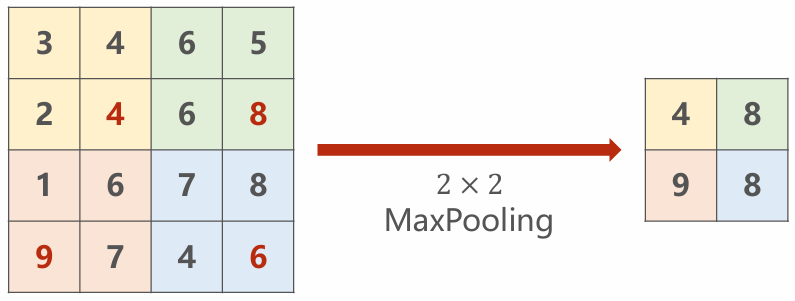
池化对通道不影响,池化前和池化后的通道数是相同的。
1.2 代码实现
我们将实现一个这样的卷积神经网络,用于 MNIST 数据集的训练。
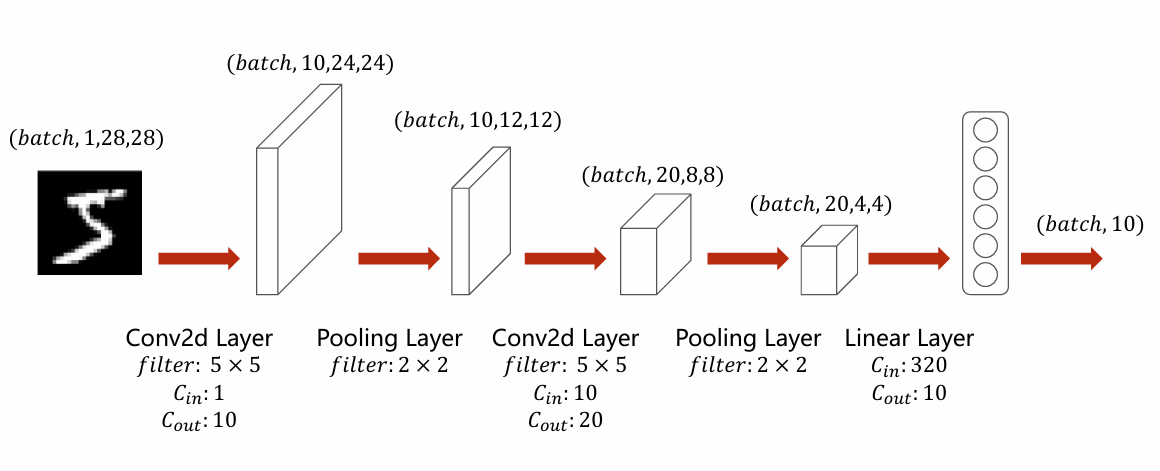
首先在 Models 包中,新增一个 MnistCNN.py:
from torch import nn

class MnistCNN(nn.Module):
    def __init__(self) -> None:
        super(MnistCNN, self).__init__()
        self.conv_1 = nn.Conv2d(1, 10, kernel_size=5)
        self.conv_2 = nn.Conv2d(10, 20, kernel_size=5)
        self.pooling = nn.MaxPool2d(2)
        self.linear = nn.Linear(320, 10)
        self.activate = nn.ReLU()

    def forward(self, x):
        batch_size = x.size(0)
        x = self.pooling(self.activate(self.conv_1(x)))
        x = self.pooling(self.activate(self.conv_2(x)))
        x = x.view(batch_size, -1)
        x = self.linear(x)
        return x
在与 Models 包同级目录下,新增 main.py:
import torch
import torch.optim as optim
from models.MnistCNN import MnistCNN
from torch.utils.data import DataLoader
from torchvision import datasets, transforms


def singleEpoch(
    epoch: int,
    train_loader: DataLoader,
    optimizer: optim.SGD,
    model: MnistCNN,
    criterion: torch.nn.CrossEntropyLoss,
):
    current_loss = 0.0
    for index, data in enumerate(train_loader, 0):
        inputs, targets = data
        optimizer.zero_grad()

        outputs = model(inputs)
        loss = criterion(outputs, targets)
        loss.backward()

        optimizer.step()

        current_loss += loss.item()

        if index % 300 == 299:
            print(f"[{epoch + 1}, {index + 1}] loss: {(current_loss / 300):.3f}")
            current_loss = 0.0


def test(
    test_loader: DataLoader,
    model: MnistCNN,
):
    correct = 0
    total = 0

    with torch.no_grad():
        for data in test_loader:
            inputs, targets = data
            ouputs = model(inputs)
            _, predicted = torch.max(ouputs.data, dim=1)
            total += targets.size(0)
            correct += (predicted == targets).sum().item()

    print(f"Accuracy on test set: {100 * correct / total} %")


def training():
    batch_size = 64
    transform = transforms.Compose(
        [transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))]
    )

    train_dataset = datasets.MNIST(
        root="data/mnist/", train=True, download=True, transform=transform
    )

    test_dataset = datasets.MNIST(
        root="data/mnist/", train=False, download=True, transform=transform
    )

    train_loader = DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
    test_loader = DataLoader(test_dataset, shuffle=False, batch_size=batch_size)

    model = MnistCNN()
    criterion = torch.nn.CrossEntropyLoss()
    optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.5)

    for epoch in range(10):
        singleEpoch(epoch, train_loader, optimizer, model, criterion)
        test(test_loader, model)


if __name__ == "__main__":
    training()
其实和之前做多分类问题的 main.py 一样,只不过换了模型而已。
运行结果:
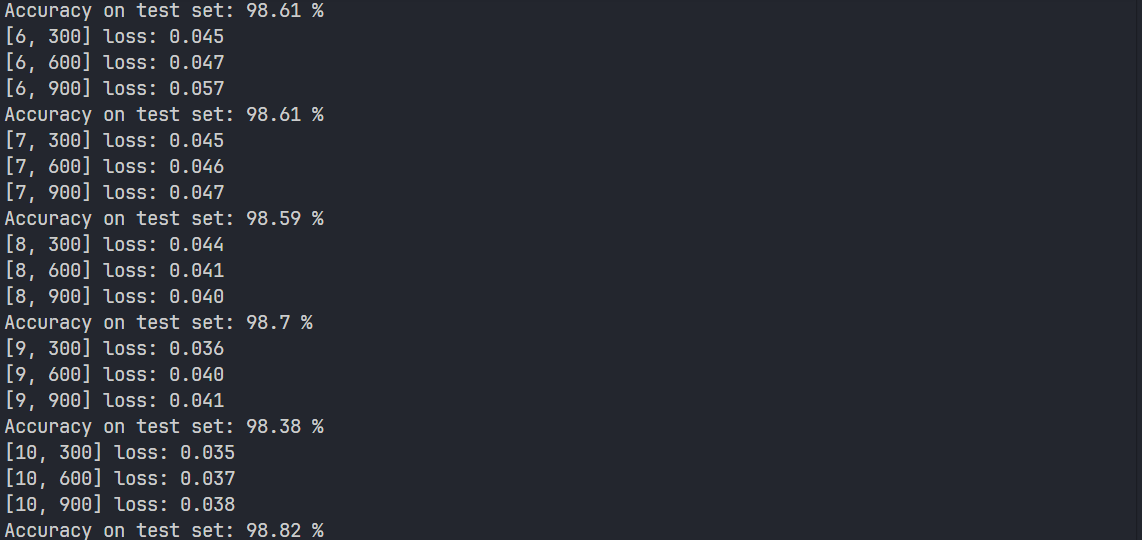
提升了 1 % 左右。
1.3 复盘
- 全连接层、全连接神经网络的概念
- 添加特征提取部分的目的
- 卷积部分包含的层数,以及每层的目的
- 卷积的计算方式
- 输入通道、卷积核、输出通道的关系
- 输出宽高的计算公式
- 共享权重的概念
- Padding 和 Stride 的作用
- 池化的主要应用方法以及作用
- 代码构建卷积神经网络的大致思路
2 卷积神经网络-高级篇
2.1 构建复杂结构的卷积神经网络
在实际的神经网络架构中,不会像之前那样那么简单。例如下方的名为 GooLeNet 神经网络:
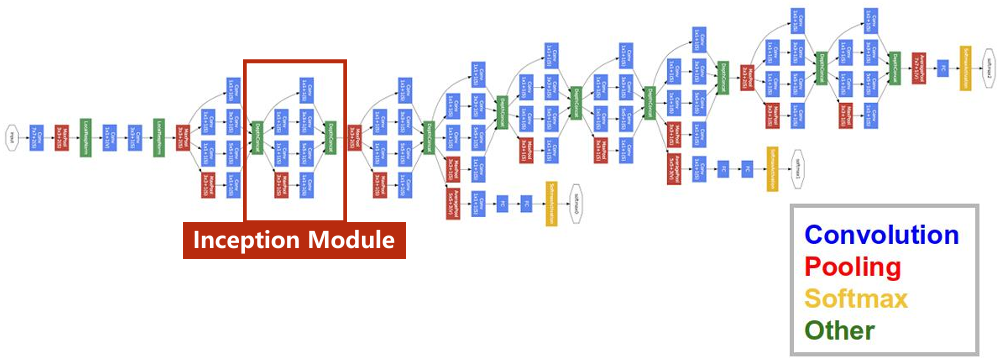
在构建时,如果一个一个的去定义这些层,那么代码会非常非常长。在学习编程时,或多或少都学习过减少代码量的方法。在面向过程编程的语言中,通常使用函数;在面向对象编程的语言中,通常使用类。
在上面的 GooLeNet 神经网络中,会发现有很多重复的部分,这些部分我们称之为 Inception Module。我们在定义神经网络时,就可以将这些 Inception Module 封装起来,需要的时候直接使用。
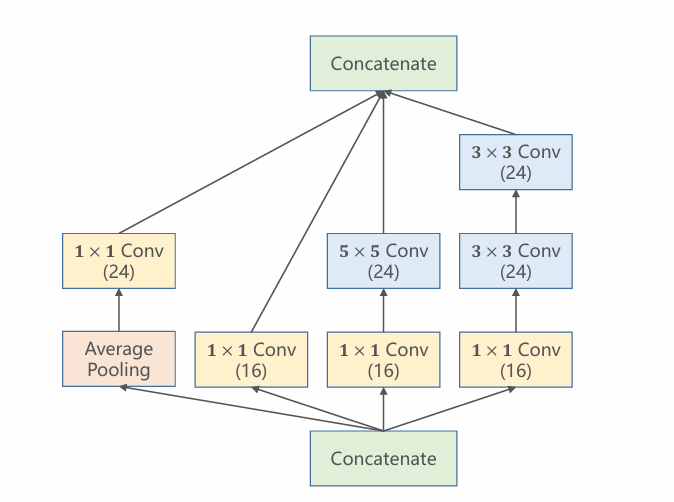
放大 GooLeNet 中的 Inception Module,除了比较常见的 3 x 3、5 x 5 的卷积层和一些池化层,还发现使用了很多 1 x 1 的卷积层。
1 x 1 的卷积层,说明卷积核是 1 x 1 的,只有一个元素。如果使用默认步长,在计算卷积的时候,等价于给输入的每个元素,都乘上一个数。结果就是输入和输出的张量的宽高不变,但是输出的通道数变小了。
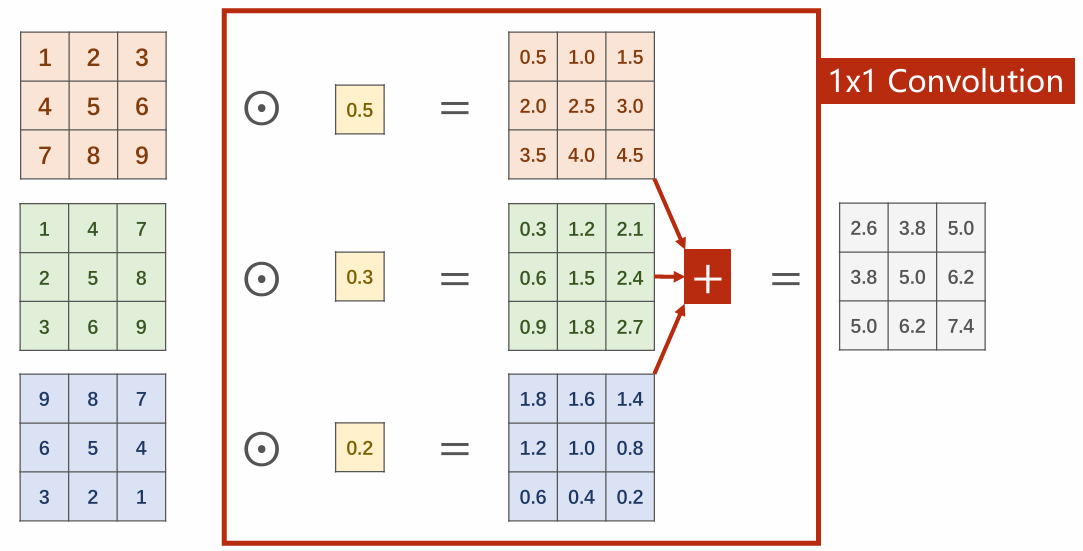
从上面的图片可以看出,经过 1 x 1 卷积运算后,最终的输出结果,有点类似于加权求和,让多个数值融合在一起。
我们知道,卷积核的通道数等于输入的通道数,输入是 3 个通道的,所以这个卷积核实际上是 3 个 1 x 1 矩阵组成的。如果使用 3 x 3 的卷积核,输入和输出的宽高就会受到影响,但是 1 x 1 的不会。并且,由于输出的通道数等于卷积核的数量,所以如果我们需要减少通道数,我们只需要将卷积核的数量减少。这有什么用呢?看下面的图:
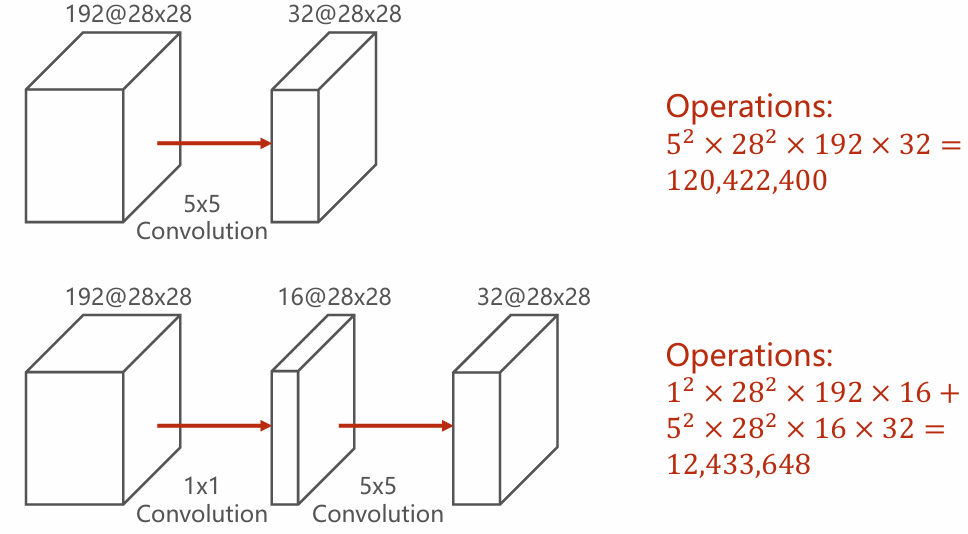
将一个 192 通道的输入,直接用 5 x 5 的卷积层运算,输出 32 个通道的结果,需要的运算次数是 1 亿 2 千多万多次,而通过 1 x 1 的卷积层降低通道数,再输出 32 个通道的结果时,运算次数减少到了 1 千 2 百多万次,减小了 10 分之 1。
并且,由于将多个数组融合的这么一个作用,其特征还能保留,也就是通过 1 x 1 的卷积层运算,可以在不影响性能的情况下,大幅减少运算量,非常有用。
接下来,我们将通过代码,集成下面的 Inception Module,来训练 Mnist 数据集:
在 Models 包中,创建一个 inceptions 包,然后再包中创建 InceptionA.py:
from torch import nn
import torch.nn.functional as F
import torch


class InceptionA(nn.Module):
    def __init__(self, in_channels) -> None:
        super(InceptionA, self).__init__()
        self.branch_1_2 = nn.Conv2d(in_channels, 24, kernel_size=1)

        self.branch_2_1 = nn.Conv2d(in_channels, 16, kernel_size=1)

        self.branch_3_1 = nn.Conv2d(in_channels, 16, kernel_size=1)
        self.branch_3_2 = nn.Conv2d(16, 24, kernel_size=5, padding=2)

        self.branch_4_1 = nn.Conv2d(in_channels, 16, kernel_size=1)
        self.branch_4_2 = nn.Conv2d(16, 24, kernel_size=3, padding=1)
        self.branch_4_3 = nn.Conv2d(24, 24, kernel_size=3, padding=1)

    def forward(self, x):
        branch_1 = F.avg_pool2d(x, kernel_size=3, stride=1, padding=1)
        branch_1 = self.branch_1_2(branch_1)

        branch_2 = self.branch_2_1(x)

        branch_3 = self.branch_3_1(x)
        branch_3 = self.branch_3_2(branch_3)

        branch_4 = self.branch_4_1(x)
        branch_4 = self.branch_4_2(branch_4)
        branch_4 = self.branch_4_3(branch_4)
        # 注意,我们最终要将结果,从通道维度合并起来。
        outputs = [branch_1, branch_2, branch_3, branch_4]
        return torch.cat(outputs, dim=1)
我这里从左往右看,每个路径是一个 branch。
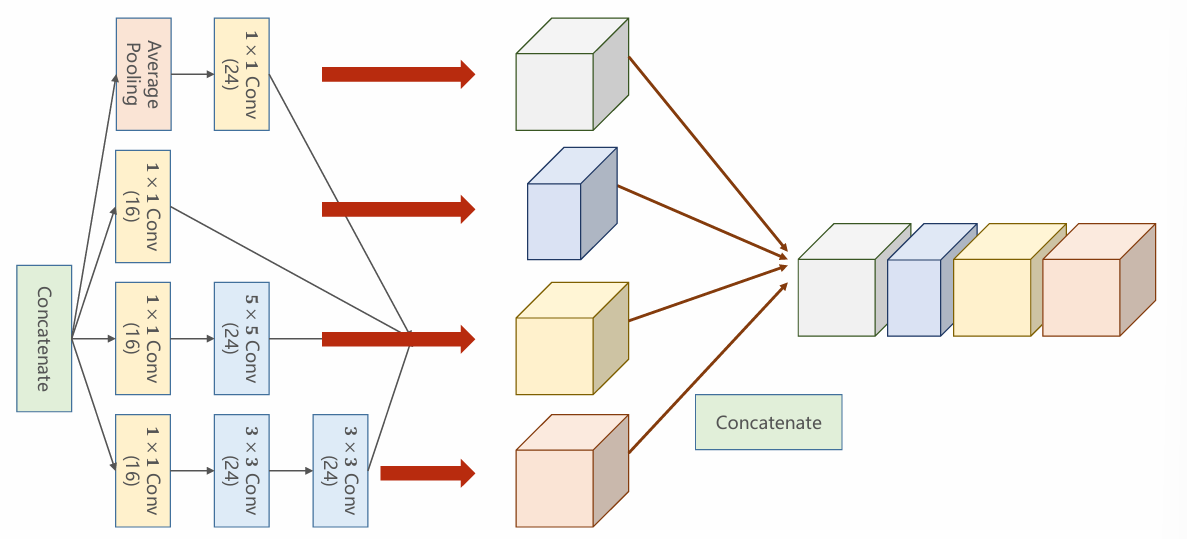 最终我们需要将各个 branch 合并起来,合并的维度就是从通道维度合并,因此输出时需要使用
torch.cat(outputs, dim=1)。
然后在 models 包中,创建 MnistInceptionCNN.py:
from models.inceptions.InceptionA import InceptionA
from torch import nn


class MnistInceptionCNN(nn.Module):
    def __init__(self) -> None:
        super(MnistInceptionCNN, self).__init__()
        self.conv_1 = nn.Conv2d(1, 10, kernel_size=5)
        self.conv_2 = nn.Conv2d(88, 20, kernel_size=5)
        # 添加两个 Inception
        self.incep1 = InceptionA(in_channels=10)
        self.incep2 = InceptionA(in_channels=20)

        self.pooling = nn.MaxPool2d(2)
        self.linear = nn.Linear(1408, 10)
        self.activate = nn.ReLU()

    def forward(self, x):
        batch_size = x.size(0)
        x = self.pooling(self.activate(self.conv_1(x)))
        # 插入使用
        x = self.incep1(x)
        x = self.pooling(self.activate(self.conv_2(x)))
        x = self.incep2(x)
        x = x.view(batch_size, -1)
        x = self.linear(x)
        return x
最后在与 models 包同级目录下,创建 main.py:
import torch
import torch.optim as optim
from models.MnistInceptionCNN import MnistInceptionCNN
from torch.utils.data import DataLoader
from torchvision import datasets, transforms


def singleEpoch(
    epoch: int,
    train_loader: DataLoader,
    optimizer: optim.SGD,
    model: MnistInceptionCNN,
    criterion: torch.nn.CrossEntropyLoss,
):
    current_loss = 0.0
    for index, data in enumerate(train_loader, 0):
        inputs, targets = data
        optimizer.zero_grad()

        outputs = model(inputs)
        loss = criterion(outputs, targets)
        loss.backward()

        optimizer.step()

        current_loss += loss.item()

        if index % 300 == 299:
            print(f"[{epoch + 1}, {index + 1}] loss: {(current_loss / 300):.3f}")
            current_loss = 0.0


def test(
    test_loader: DataLoader,
    model: MnistInceptionCNN,
):
    correct = 0
    total = 0

    with torch.no_grad():
        for data in test_loader:
            inputs, targets = data
            ouputs = model(inputs)
            _, predicted = torch.max(ouputs.data, dim=1)
            total += targets.size(0)
            correct += (predicted == targets).sum().item()

    print(f"Accuracy on test set: {100 * correct / total} %")


def training():
    batch_size = 64
    transform = transforms.Compose(
        [transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))]
    )

    train_dataset = datasets.MNIST(
        root="data/mnist/", train=True, download=True, transform=transform
    )

    test_dataset = datasets.MNIST(
        root="data/mnist/", train=False, download=True, transform=transform
    )

    train_loader = DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
    test_loader = DataLoader(test_dataset, shuffle=False, batch_size=batch_size)

    model = MnistInceptionCNN()
    criterion = torch.nn.CrossEntropyLoss()
    optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.5)

    for epoch in range(10):
        singleEpoch(epoch, train_loader, optimizer, model, criterion)
        test(test_loader, model)


if __name__ == "__main__":
    training()
同样的流程,只是换个模型而已。
运行结果:
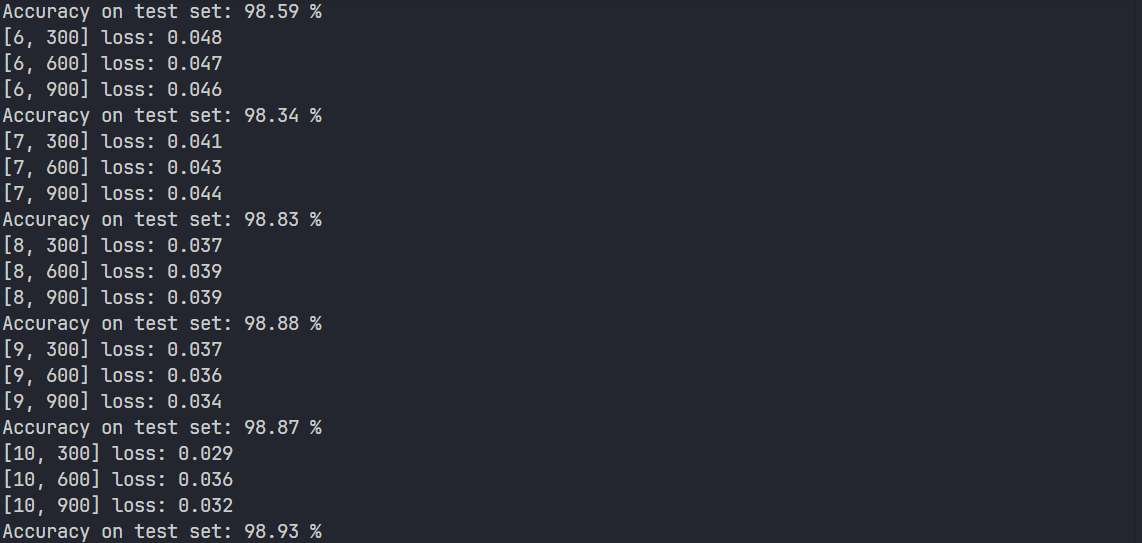
略有上升,但可以说没有什么变化,因为本身思路上没有变化,只是增加了神经网络的层数而已。
2.2 解决梯度消失问题
一篇论文:
He K, Zhang X, Ren S, et al. Deep Residual Learning for Image Recognition[C]// IEEE Conference on Computer Vision and Pattern Recognition. IEEE Computer Society, 2016:770-778.讨论了一个问题,就是如果把神经网络的层数不断增多,训练效果是否会更好,下面是它的实践结果:
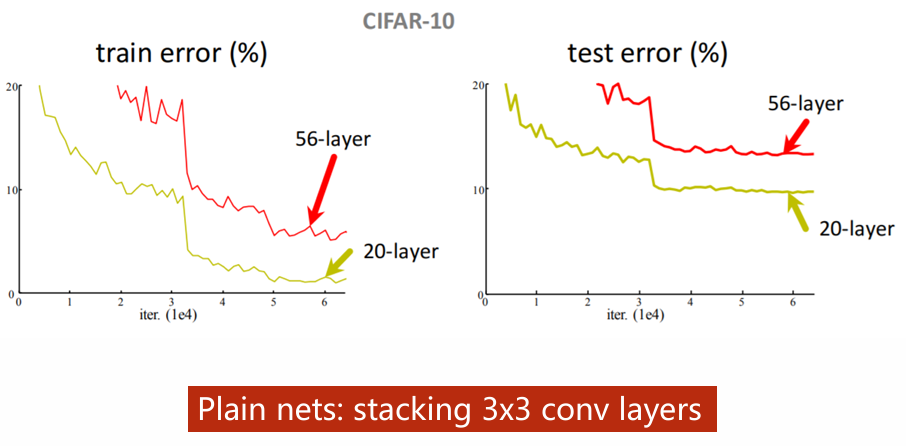
从图中看出,20 层的神经网络的错误率,不论是在训练集还是在测试集上,都比 56 层的神经网络要低。出现这个的原因,其实是因为梯度消失。我们知道,梯度下降的公式是:
在反向传播过程中,梯度的传播主要依靠导数的链式法则,主要就是导数乘法。但如果梯度的值是小于 1 的,那么在累乘的过程中,梯度会越来越小,趋近于0。根据梯度下降公式,当梯度趋近于 0 时,权重几乎不更新,因此训练效果会不好。
为了解决这个问题,有人提出了名为:Deep Residual Learning 深度残差学习的概念,简单来说,它通过一种名为跳跃连接(Skip Connection)的设计,巧妙解决了在训练极深神经网络时的梯度消失问题。
跳跃连接,指的是将输出的值,跳跃性的加到某一层的输出中,再传递给下一层。不一定是加,也可能是其他运算(有其他的连接方法)。如图所示:
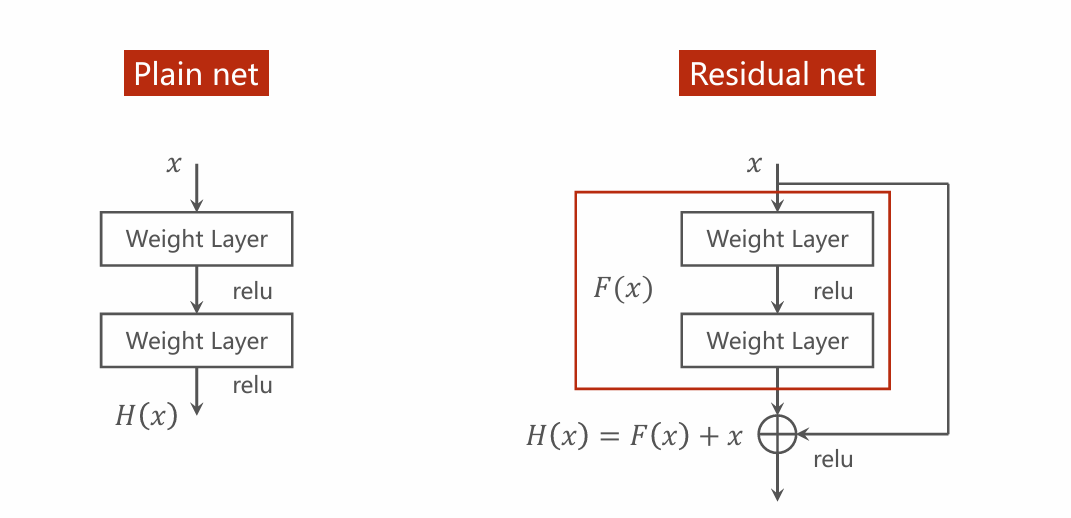
在最终的输出中,由于加上了输出,其公式的导数为:
正是因为这个 ,避免了梯度在累乘后变小的问题,使得梯度得到有效传播。使用这种方式的神经网络,也成为残差网络(ResNet)。
接下来,通过代码来实现这个功能,继续训练 Mnist 数据集。在 models 目录中,新增一个 residuals 包,在包中新增 ResidualBlock.py:
from torch import nn

class ResidualBlock(nn.Module):
    def __init__(self, in_channels) -> None:
        super(ResidualBlock, self).__init__()
        self.channels = in_channels
        self.conv_1 = nn.Conv2d(self.channels, self.channels, kernel_size=3, padding=1)
        self.conv_2 = nn.Conv2d(self.channels, self.channels, kernel_size=3, padding=1)
        self.activate = nn.ReLU()

    def forward(self, x):
        y = self.activate(self.conv_1(x))
        y = self.conv_2(y)
        # 这里执行 x + y 再激活
        return self.activate(x + y)
然后在 models 包中,创建 MnistResidualNet.py:
from torch import nn

from models.residuals.ResidualBlock import ResidualBlock


class MnistResidualNet(nn.Module):
    def __init__(self) -> None:
        super(MnistResidualNet, self).__init__()
        self.conv_1 = nn.Conv2d(1, 16, kernel_size=5)
        self.conv_2 = nn.Conv2d(16, 32, kernel_size=5)
        self.pooling = nn.MaxPool2d(2)
        # 创建残差块
        self.rblock_1 = ResidualBlock(16)
        self.rblock_2 = ResidualBlock(32)

        self.linear = nn.Linear(512, 10)
        self.activate = nn.ReLU()

    def forward(self, x):
        batch_size = x.size(0)
        x = self.pooling(self.activate(self.conv_1(x)))
        # 进行一次连接
        x = self.rblock_1(x)
        x = self.pooling(self.activate(self.conv_2(x)))
        # 进行一次连接
        x = self.rblock_2(x)
        x = x.view(batch_size, -1)
        x = self.linear(x)
        return x
最后,在与 models 包同级的包下,创建 main.py,依旧是之前的代码换个模型:
import torch
import torch.optim as optim
from models.MnistResidualNet import MnistResidualNet
from torch.utils.data import DataLoader
from torchvision import datasets, transforms


def singleEpoch(
    epoch: int,
    train_loader: DataLoader,
    optimizer: optim.SGD,
    model: MnistResidualNet,
    criterion: torch.nn.CrossEntropyLoss,
):
    current_loss = 0.0
    for index, data in enumerate(train_loader, 0):
        inputs, targets = data
        optimizer.zero_grad()

        outputs = model(inputs)
        loss = criterion(outputs, targets)
        loss.backward()

        optimizer.step()

        current_loss += loss.item()

        if index % 300 == 299:
            print(f"[{epoch + 1}, {index + 1}] loss: {(current_loss / 300):.3f}")
            current_loss = 0.0


def test(
    test_loader: DataLoader,
    model: MnistResidualNet,
):
    correct = 0
    total = 0

    with torch.no_grad():
        for data in test_loader:
            inputs, targets = data
            ouputs = model(inputs)
            _, predicted = torch.max(ouputs.data, dim=1)
            total += targets.size(0)
            correct += (predicted == targets).sum().item()

    print(f"Accuracy on test set: {100 * correct / total} %")


def training():
    batch_size = 64
    transform = transforms.Compose(
        [transforms.ToTensor(), transforms.Normalize((0.1307,), (0.3081,))]
    )

    train_dataset = datasets.MNIST(
        root="data/mnist/", train=True, download=True, transform=transform
    )

    test_dataset = datasets.MNIST(
        root="data/mnist/", train=False, download=True, transform=transform
    )

    train_loader = DataLoader(train_dataset, shuffle=True, batch_size=batch_size)
    test_loader = DataLoader(test_dataset, shuffle=False, batch_size=batch_size)

    model = MnistResidualNet()
    criterion = torch.nn.CrossEntropyLoss()
    optimizer = optim.SGD(model.parameters(), lr=0.01, momentum=0.5)

    for epoch in range(10):
        singleEpoch(epoch, train_loader, optimizer, model, criterion)
        test(test_loader, model)


if __name__ == "__main__":
    training()
运行结果:
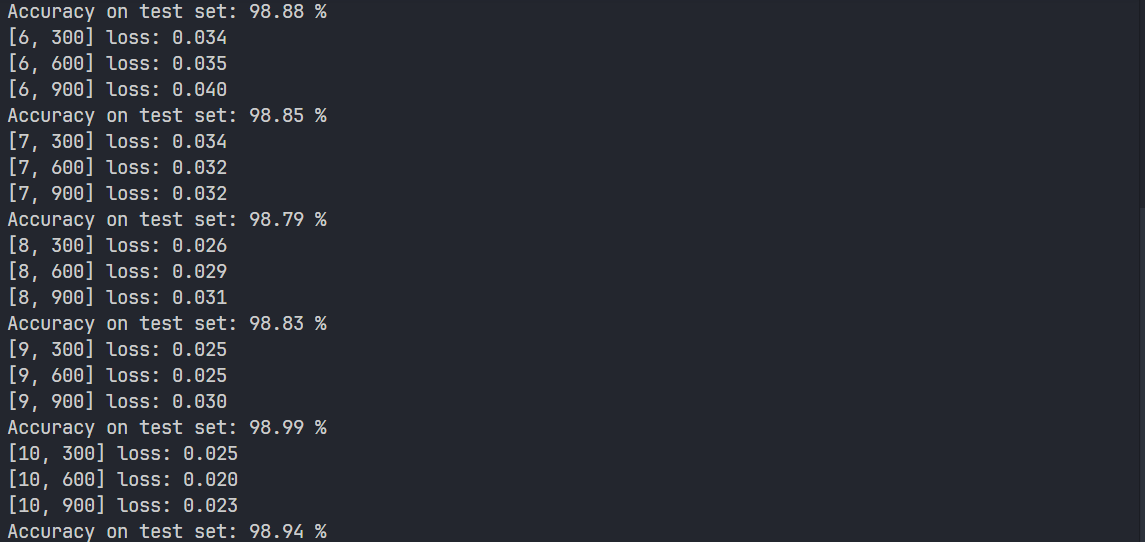
现在,几乎可以突破 99 % 了,老师那边训练出来是 99% ,但是我这没有。但是从最后两轮的损失来看,确实可以说突破到 99 %了。
2.3 复盘
- Inception Module 的概念
- 1 x 1 的卷积层的作用
- 代码中实现 Inception Module 并应用到神经网络中的大致思路
- 梯度消失问题出现的原因
- 深度残差网络的特点
- 深度残差网络解决梯度消失问题的方法
- 代码中实现深度残差网络的大致思路
3 循环神经网络-基础篇
3.1 循环神经网络学习
假设有一个场景,我需要训练一个模型,它需要根据过去连续多天的天气数据,例如日期、温度、气压等等,来预测明天是否要下雨。
如果使用全连接神经网络,我们知道,全连接的神经网络其对每个输入矩阵的元素,都要计算和存储梯度和权重。如果我需要使用 30 天的数据进行训练,每天有大概 10 个特征点(温度、气压这些),那么输入样本就是 300 个数据。以我们之前的全连接神经网络的代码为例:
from torch import nn


class MnistNet(nn.Module):
    def __init__(self) -> None:
        super(MnistNet, self).__init__()
        self.linear_1 = nn.Linear(300, 128)
        self.linear_2 = nn.Linear(128, 64)
        self.linear_3 = nn.Linear(64, 32)
        self.linear_4 = nn.Linear(32, 1)
        self.activate_1 = nn.ReLU()

    def forward(self, x):
        x = x.view(-1, 300)
        x = self.activate_1(self.linear_1(x))
        x = self.activate_1(self.linear_2(x))
        x = self.activate_1(self.linear_3(x))
        return self.linear_4(x)
通常不会直接将300直接降到 1, 通常是一层一层的降维计算,就第一层来说,我们需要输出128 x 1 的结果,那么由线性回归模型的公式: ,x 是 300 x 1, 是 128 x 1,那么我们的 的维度就需要是 128 x 300,直接就有 38400 个权重参数。如果不是 30 天,是 100 天,那么参数会更多。以天气来说还好,如果是处理视频这种,视频都是以帧为单位,输出都是图片这种三维数据(我们之前的手写字图片 1 x 28 x 28 的都有 784 的输入长度),那一个视频的参数量就极大了,内存可能会被撑爆。
卷积神经网络因为引入卷积层,使用了共享权重,维护的权重参数会比全连接神经网络要小。全连接神经网络和卷积神经网络,处理的都是空间上的信息。在天气预测这个例子里,我们需要根据 30 天的训练集训练,那么我们的卷积核就应当涵盖30天的数据,也就是通道数要变成 30 ,如果是 100 天,那就要更大,运算量很大。如果我们固定 3 x 3,那么卷积核就只会看 3 天内的天气,更早的可能认为是无关的。
总结来说,就是全连接或者卷积神经网络,对空间信息的处理很好,但是对时间这种连续的序列信息,可能会难以理解。
而循环神经网络(RNN,Recurrent Neural Network)正是为了解决这个问题的。循环神经网络的基本结构如下:
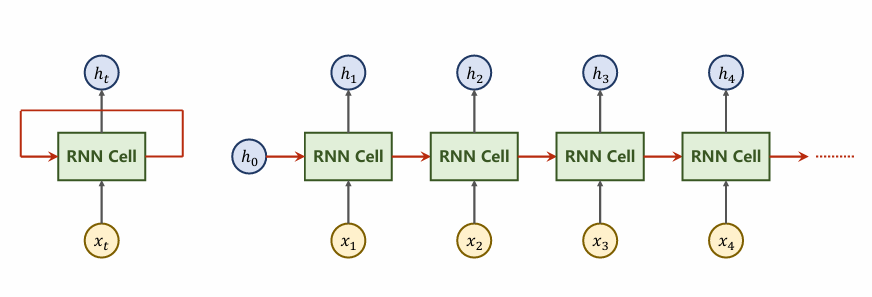
左边是合并写法,右边是展开写法
RNN Cell 是一个线性层,x1 输入到 RNN Cell 后,经过线性运算,得到结果 h1,然后将 h1 和 x2 再次输入到 RNN Cell,进行下一次循环运算,直到输入结束,这便是循环的过程。其中 这一层,叫做 hidden 隐藏层。 叫做先验,如果由先验数据,就可以输入进来。
既然输入是 ,输出是 ,那么我们在进行线性运算时, 的大小就是由 和 决定的, 的大小称为 input_size , 的大小称为 hidden_size。在循环神经网络中,具体的运算过程是这样的:
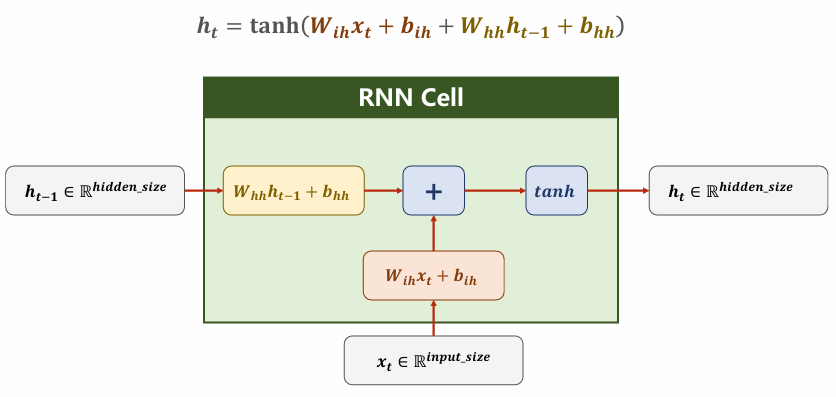
tanh 是 RNN 常用的激活函数。
接下来通过一个简单的练习,了解 RNN 的训练过程,题目如下:
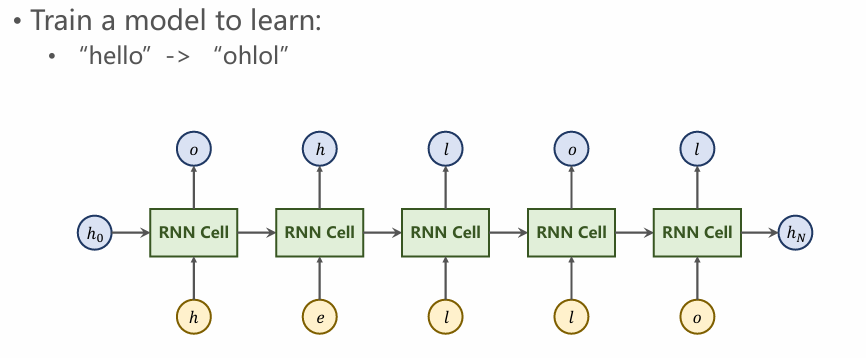
将 hello 这字符序列,训练为 ohlol。由于是处理字符串,而不是数值,所以这里需要做一下变换,将字符串变成数值形式。通常的变换方法很简单,就是构建词典,将 hello 出现的每个字符,都用一个索引进行映射。这样,我们就将字符串,变成了一个整型向量,而这个向量就是一个经典多分类。我们之前处理多分类的时候,用的 One-Hot 独热编码,这里也同样用独热编码:
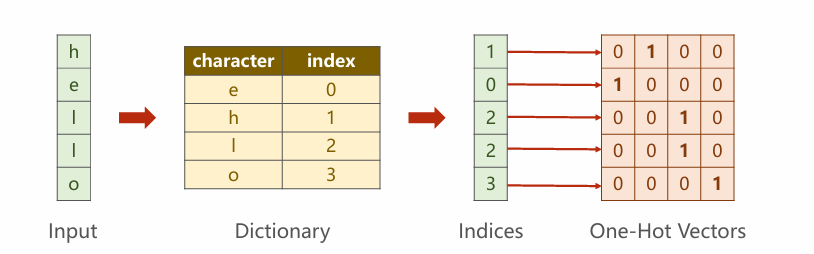
从最终的独热向量中可以看出,输入的 inputSize 是 4 。
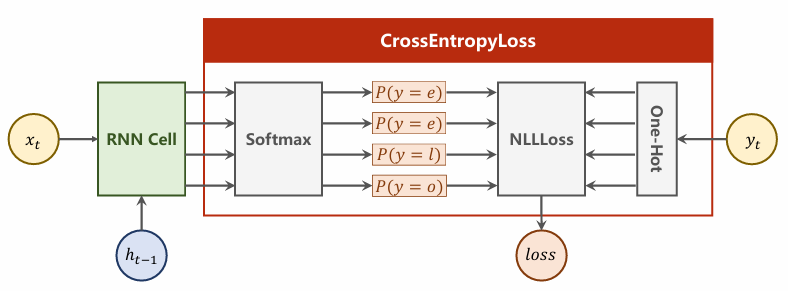
既然是多分类问题,那激活函数和损失函数就好找了,就是 Softmax 和 NLLLoss,合并称为 CrossEntropyLoss 交叉熵损失。此外,我们的输出序列是:ohlol,同样是个 5 x 4 的矩阵,那么 outputSize,或者说 hiddenSize 就是 4 了。
开始编写代码,首先在 models 包下,新建一个 CharRNN.py:
from torch import nn
import torch

class CharRNN(nn.Module):
    def __init__(self, input_size, hidden_size, batch_size, num_layers = 1) -> None:
        super(CharRNN, self).__init__()
        self.num_layers = num_layers
        self.batch_size = batch_size
        self.input_size = input_size
        self.hidden_size = hidden_size
        self.rnn = nn.RNN(
            input_size=self.input_size,
            hidden_size=self.hidden_size,
            num_layers=num_layers
        )

    def forward(self, x):
        # 初始化 h0
        hidden = torch.zeros(
            self.num_layers,
            self.batch_size,
            self.hidden_size
        )

        out, _ = self.rnn(x, hidden)
        return out.view(-1, self.hidden_size)
然后在与 model 同级的目录下,创建 main.py:
import torch
from models.CharRNN import CharRNN

# 构建字符与索引的词典
idx2char = ['e', 'h', 'l', 'o']
# 输入 hello
x_data = [1, 0, 2, 2, 3]
# 输出 ohlol
y_data = [3, 1, 2, 3, 2]
# 构建独热编码
one_hot_lookup = [
    [1, 0, 0, 0],
    [0, 1, 0, 0],
    [0, 0, 1, 0],
    [0, 0, 0, 1]
]
# 根据 x_data 将相应的独热编码排列成输入参数
x_one_hot = [one_hot_lookup[x] for x in x_data]

def training():
    # 初始化值
    input_size = 4
    hidden_size = 4
    num_layers = 1
    batch_size = 1
    sql_len = 5

    # 构建输入张量,
    inputs = torch.Tensor(x_one_hot).view(sql_len, batch_size, input_size)
    # 输出张量
    targets = torch.LongTensor(y_data)
    # 模型、损失函数、优化器
    model = CharRNN(input_size, hidden_size, batch_size, num_layers)
    criterion = torch.nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.05)

    # 训练 15 轮
    for epoch in range(15):
        # 和之前一样的流程
        outputs = model(inputs)

        loss = criterion(outputs, targets)

        optimizer.zero_grad()
        loss.backward()

        optimizer.step()

        _, idx = outputs.max(dim=1)
        idx = idx.data.numpy()
        print("Predicted:", "".join([idx2char[x] for x in idx]), end="")
        print(", Epoch [%d/15] loss = %.3f" % (epoch + 1, loss.item()))

if __name__ == "__main__":
    training()
num_layers 是 RNN Cell 的层数,如果 num_layers 大于 1,那神经网络就会变成这样:
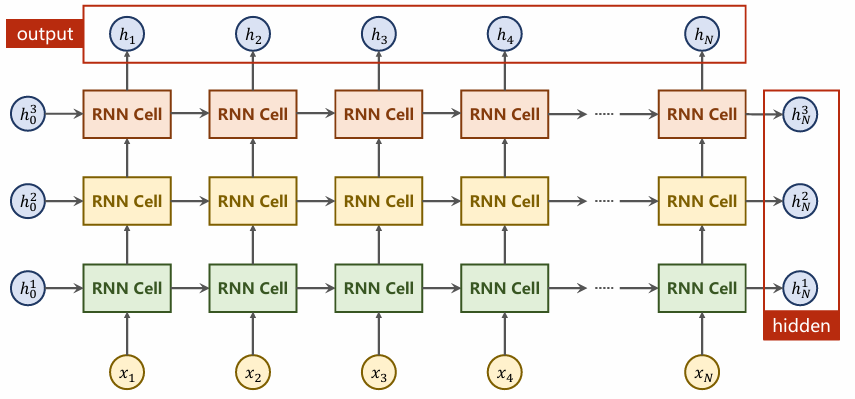
inputs 的形状为什么是(seg_len,batch_size,input_size)?seg_len 是样本 x 的数量,这里是 5 ,batch_size 是 mini-batch 大小,input_size 是 x 的 feature 数。这些输入是 RNN 的要求。
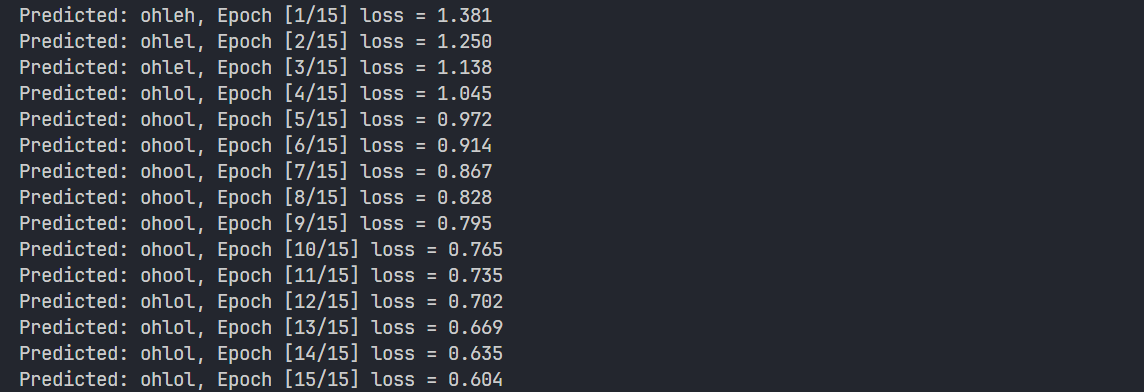
运行结果:
3.2 Embedding 、LSTM、GRU
独热编码的弊端:
- 维度高。如果我们上面的输入不是 hello 而是一个很长的句子,那么独热编码的维度就会暴增。
- 向量稀疏。独热编码的有效元素都是几个点,很稀疏。
- 硬编码。独热编码需要根据输入进行硬编码,不灵活。
为了解决这个问题,比较常用的方法是引入 Embedding(嵌入)层。Embedding 指的是将一个高维的、稀疏的样本,映射到一个低维的、稠密的空间中,也就是数据的降维。
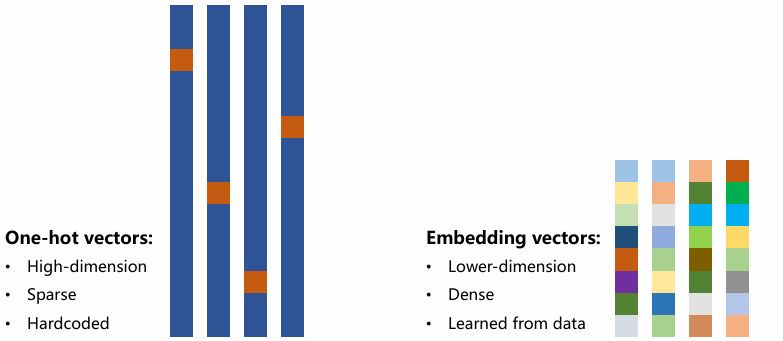
以之前的词表为例,在这个嵌入层当中,会建立一个尺寸为 [词表大小, 嵌入维度]的一个权重矩阵(查表字典)。当输入的索引 1 (代表 'h')传入嵌入层时,模型会将权重矩阵中的第 1 行数据拿出来,作为 RNN Cell 的输入。并且呢,当模型进行反向传播更新权重的时候,会顺带更新嵌入层的权重矩阵中的权重,成为了一种‘Learned from data’的向量。
如何在 RNN 中使用 embedding 呢?其实很简单,首先在models包下创建一个文件 CharEmbRNN.py:
from torch import nn
import torch

class CharEmbRNN(nn.Module):
    def __init__(self, input_size, hidden_size, batch_size, embedding_size, class_num, num_layers = 1) -> None:
        super(CharEmbRNN, self).__init__()
        self.num_layers = num_layers
        self.batch_size = batch_size
        self.input_size = input_size
        self.hidden_size = hidden_size
        self.embedding_size = embedding_size
        self.class_num = class_num
        # 注意嵌入层的形状
        self.emb = nn.Embedding(self.input_size, self.embedding_size)
        # 由于输入从嵌入层来,输入形状也要改成嵌入层输出的形状
        self.rnn = nn.RNN(
            input_size=self.embedding_size,
            hidden_size=self.hidden_size,
            num_layers=self.num_layers
        )
        # 由于 hidden_size 是 8,要将其转化为 4。
        self.linear = nn.Linear(self.hidden_size, self.class_num)

    def forward(self, x):
        hidden = torch.zeros(
            self.num_layers,
            self.batch_size,
            self.hidden_size
        )
        x = self.emb(x)
        x, _ = self.rnn(x, hidden)
        x = self.linear(x)
        # 输出是 (seg_len, batch_size, hidden_size)
        # 因为交叉熵损失需要(样本数,类别数)这样一个矩阵
        # 所有这里得变一下形状(seg_len * batch_size, class_num)
        return x.view(-1, self.class_num)
对于维度的变化,可能有点晕,这里重新组织一下: 对于 RNN Cell 来说,其输入和输出维度分别是(seg_len, batch_size, input_size)和(seg_len, batch_size, hidden_size)。通常 hidden_size 都会设为 4(就像之前那样),直接输出结果,但这里模拟未输出正确维度的结果,所以设为 8 。
对于 Embedding 来说,其要将一个稀疏的输入转化为稠密的权重矩阵。这里,我们构建的 Embedding 的权重矩阵大小是(input_size, embedding_size)。当我们输入形状为(seg_len,batch_size)的输入时,seg_len 中的索引,查询权重矩阵,将那一行的数据(1,embedding_size )拿出来,放在对于的位置,全部查询完成后,输入形状就变成了(seg_len,batch_size ,embedding_size)。
由于 Embedding 层存在,所以 RNN Cell 的输入是(seg_len, batch_size, embedding_size)和(seg_len, batch_size, hidden_size)。然后,线性层将 RNN Cell 的输入(seg_len, batch_size, hidden_size),转化为 (seg_len, batch_size, class_num)。为了满足就交叉熵的要求,最后的输出结果就是将 (seg_len, batch_size, class_num),转化为 (seg_len x batch_size, class_num)
所以,维度的变化流程是:
- 输入:(seg_len, batch_size) -> (5, 1)
- Embedding:(seg_len, batch_size, embedding_size) -> (5, 1, 10)
- RNN Cell:(seg_len, batch_size, hidden_size) -> (5, 1, 8)
- Linear:(seg_len, batch_size, class_num) -> (5, 1, 4)
- 输出:(seg_len x batch_size, class_num) -> (5·1, 4) = (5, 4)
接下来,在与 models 包同级目录下, 创建 main.py:
import torch
from models.CharEmbRNN import CharEmbRNN

# 不需要独热编码
idx2char = ["e", "h", "l", "o"]
x_data = [1, 0, 2, 2, 3]
y_data = [3, 1, 2, 3, 2]


def training():
    class_num = len(idx2char) # 类别数量
    input_size = 4 # 输入维度
    hidden_size = 8 # 隐层维度
    embedding_size = 10 # 嵌入层维度
    num_layers = 2 # RNN Cell 层数
    batch_size = 1 # Mini Batch 数
    sql_len = 5 # 序列数(样本数)

    # 将输入转为(5,1)
    inputs = torch.LongTensor(x_data).view(sql_len, batch_size)
    targets = torch.LongTensor(y_data)

    model = CharEmbRNN(
        input_size, hidden_size, batch_size, embedding_size, class_num, num_layers
    )
    criterion = torch.nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.05)

    for epoch in range(15):
        outputs = model(inputs)
        loss = criterion(outputs, targets)

        optimizer.zero_grad()
        loss.backward()

        optimizer.step()

        _, idx = outputs.max(dim=1)
        idx = idx.data.numpy()
        print("Predicted:", "".join([idx2char[x] for x in idx]), end="")
        print(", Epoch [%d/15] loss = %.3f" % (epoch + 1, loss.item()))


if __name__ == "__main__":
    training()
运行结果:
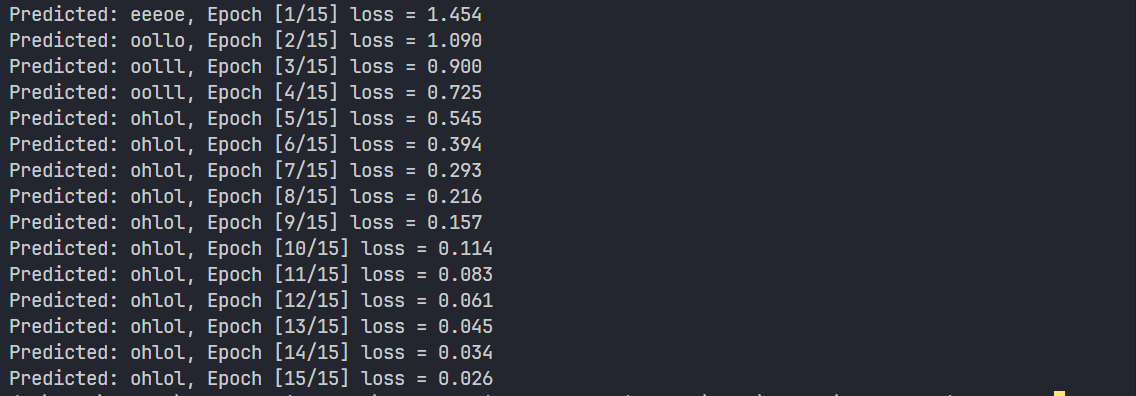
可以看到,更早地获取到了正确的结果。
接下来的内容老师一笔带过,我这里结合 DS 的说法简单过一下。
LSTM 全称长短期记忆网络(Long Short-Term Memory),它是循环神经网络的一个变体。在传统 RNN 中,在处理长序列数据时,会容易出现遗忘,越靠后的内容就越容易忽略开头的信息,也就是梯度消失问题;或者返过来,被开头的信息干扰,也就是梯度爆炸问题。LSTM 专门设计了一套机制来解决这些问题。
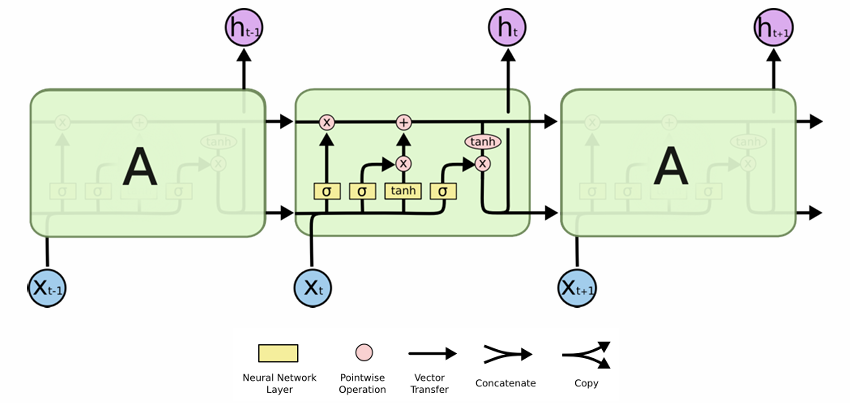
LSTM 内部有三个关键的门:
- 遗忘门(Forget Gate):决定将哪些旧信息从记忆中去除。
- 输入门(Input Gate):决定把哪些新信息存入记忆。
- 输出门(Output Gate):决定当前时刻需要数据什么信息。 在工作时,LSTM 的数据会沿着一条水平线(类似转送带)一样,在每个时间步中,遗忘门清理旧信息,输入门写入新信息,输出门决定将什么结果传递给下一层。这种设计可以让模型能选择性地记忆时间步跨度很长的信息。
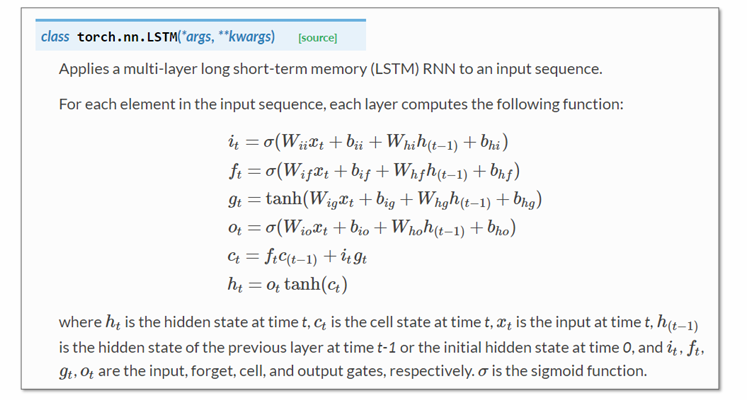
LSTM 的实现主要来源这几个公式:
GRU 的全称是门控循环单元(Gated Recurrent Unit),也是 RNN 的变体。GRU 也是通过门控机制完成记忆管理,但是它的结构比 LSTM 更加精简,参数更少,运算更快。GRU 只有两个核心的门:
- 更新门(Update Gate):它是 LSTM 遗忘门和输入门的合并,它产生一个 0~1 之间的数值。数值越大,代表保留的旧记忆越多;数值越小,代表写入的新信息越多。可以同时决定保留多少与写入多少。
- 重置门(Reset Gate):决定忽略多少过去的信息,如果重置门数值接近 0,就意味着模型决定“暂时忘掉之前的状态”,把当前输入当作一段全新的开始来处理。这能帮助模型捕捉序列中短期的依赖关系。
它们两者的其他区别:
| 维度 | LSTM | GRU |
|---|---|---|
| 结构 | 3个门(遗忘、输入、输出)+ 1个细胞状态 | 2个门(更新、重置),无细胞状态 |
| 参数量 | 多(约是 GRU 的 1.5 倍) | 少(训练更快,更省显存) |
| 数据需求 | 适合超大规模数据集,复杂模式捕捉能力上限更高 | 适合中小规模数据集,不易过拟合 |
| 训练速度 | 较慢 | 较快 |
| 适用场景 | 语音识别、机器翻译等极长序列的复杂任务 | 文本情感分析、短句预测、实时性要求高的场景 |
DS 说这两者现在都被 Transformer (注意力机制)替代了。
3.3 复盘
- 循环神经网络(RNN)设计的目的
- RNN 的主要结构
- 代码实现 RNN 的大致思路
- Embedding 的概念和作用
- LSTM、GRU 的概念与大致的设计思想
4 循环神经网络-高级篇
4.1 RNN Classifier
有如下的场景:
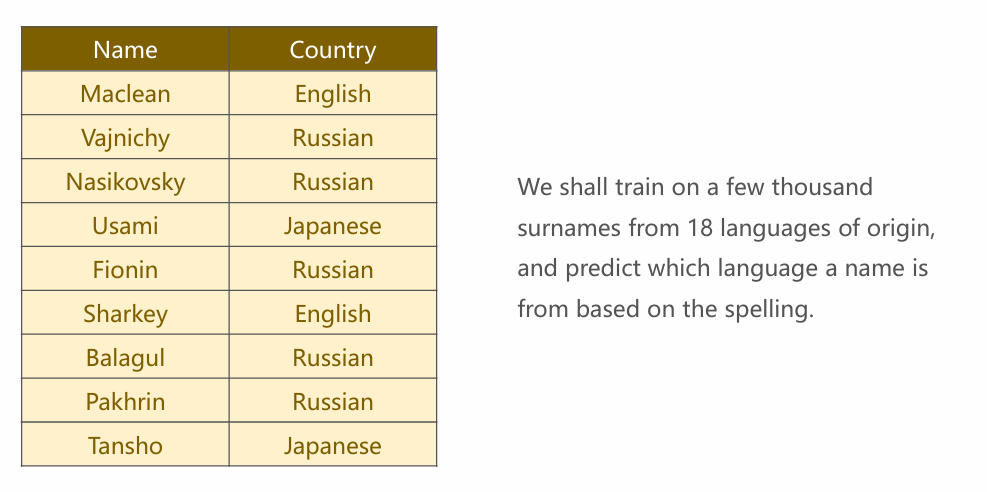
我们需要训练一个 RNN,它能够根据 Name 的拼写方式,输出这是属于哪种语言(国家)。这是一个多分类问题,并且由于处理的是字符串名字,其有明显的时间顺序关系(字符先后出现),所以需要使用 RNN 来实现。
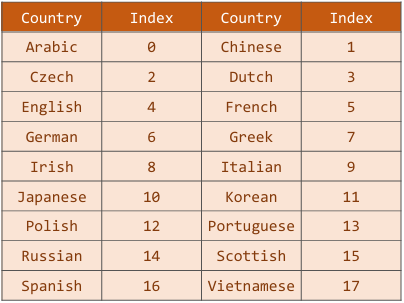
在处理之前,需要对原有的数据进行处理。对于输出,处理方法很简单,就是将常见的 18 种国家,做出分类:
输入依旧使用的是构建词表方法,不过由于这里的字符数量很多,所以字符索引就不单独设置了,直接使用 ASCII 码来做:
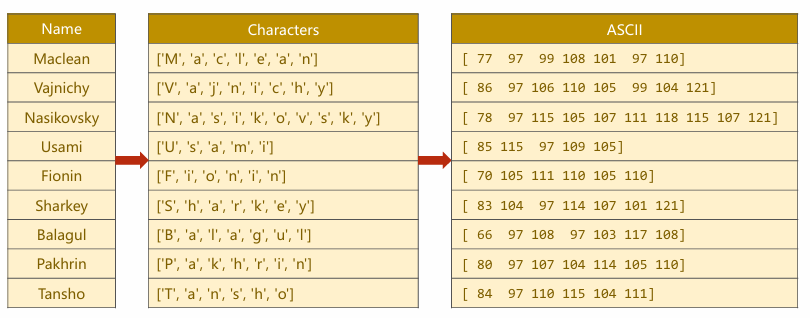
为了保持输入数据维度的一致性,还需要统一一下词表的长度:
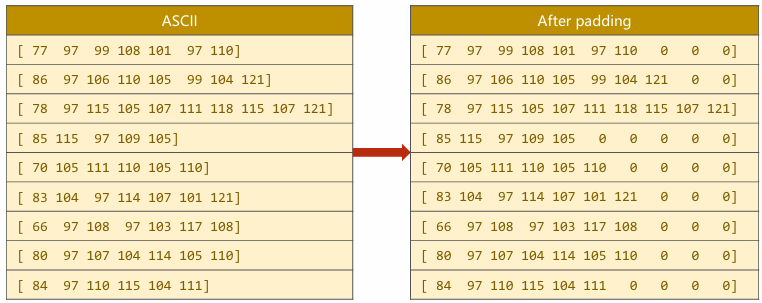
但是,我们可以看到,最终的这个输入矩阵形状不对。因为我们的嵌入层要求输入是(seg_len, batch_size),现在这个结构则是(batch_size, seg_len),所以我们需要对这个矩阵做一下转置:
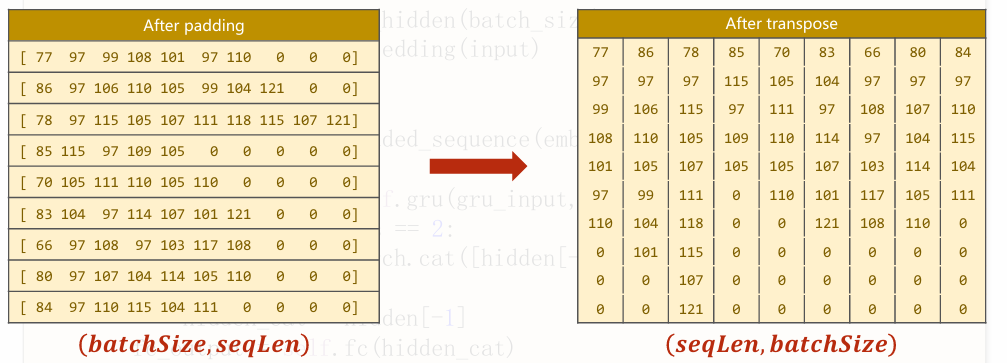
这里呢,还需要做一些操作。从上面的矩阵中可以看出,它们是一个变长序列,为了统一长度,添加了大量的无用填充值。这些无用的填充值在实际运算时,会导致算力和内存的浪费。为了解决这个问题,这里介绍一个名为 PackedSequence 的技术。
在 torch 中,提供了相应的方法实现 pack_padded_sequence。它硬性要求输入的序列必须是一个降序排列的(长序列在前,短序列在后)。如图所示:
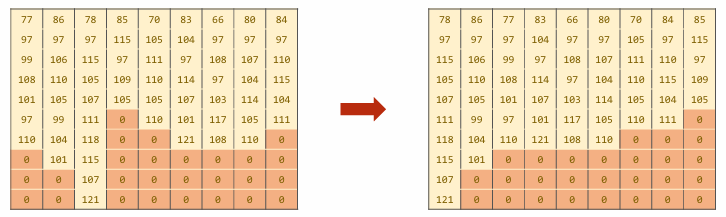
这么做的目的是为了提高运行效率,在计算时,RNN 只需要知道每个 batch_size 的长度,就可以直接处理指定长度的 batch,忽略掉那些 0。此外,为了彻底去除掉 0 ,pack_padded_sequence 函数将每个 batch 按顺序前后相接,形成一个单列的长向量:
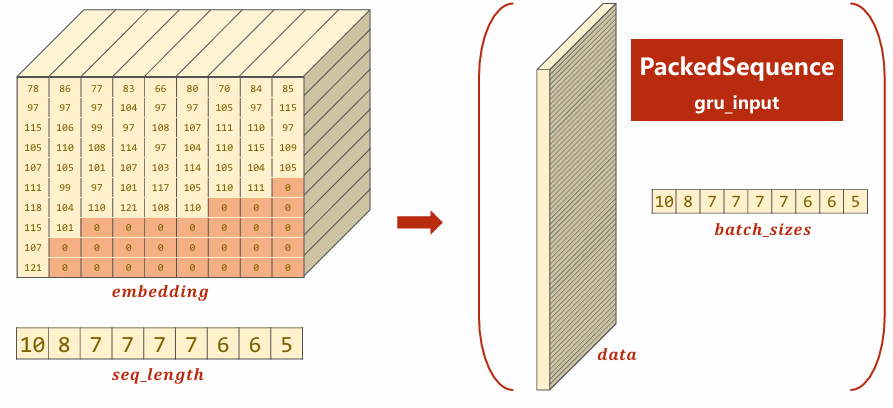
老师这里的 batch_size 写错了,应该是
[10, 10, 10, 10, 10, 9, 7, 2, 1, 1]
变成 PackedSequence 后,RNN 就不会将内存和算力浪费在无意义的填充零上了,运行的效率会更高。通过这些转换,就可以将原本的字符串名字映射成数字了,然后就可以通过嵌入层进行转化。
在编写代码之前呢,还需要了解单向和双向循环神经网络。在之前的循环神经网络中,我们实现的是单向的循环神经网络。单向的循环神经网络依赖于过去的数据,例如通过过去的出现的词,判断下一个词是什么;而双向的循环神经网络不仅依赖之前的数据,还依赖之后的数据,例如通过过去出现的词,以及之后出现的词,判断某个位置应该是什么词。
在单向循环神经网络,只有一个信息传递方向,在时间步 中,它的 只由 和 当前的 所决定。在双向循环神经网络中,由两个独立的隐藏层构成:前向层(Forward)从序列开头向结尾传播(用于记住上文);后向层(Backward)从序列结尾向开头传播(记住下文)。最终,在时间步 的输出,是由前向层的输出和后向层的输出做拼接(Concatenate)而得出的。这两个层在训练过程中不会相互传递信息,只会在最终输出时汇合。双向循环神经网络的结构展开如下:
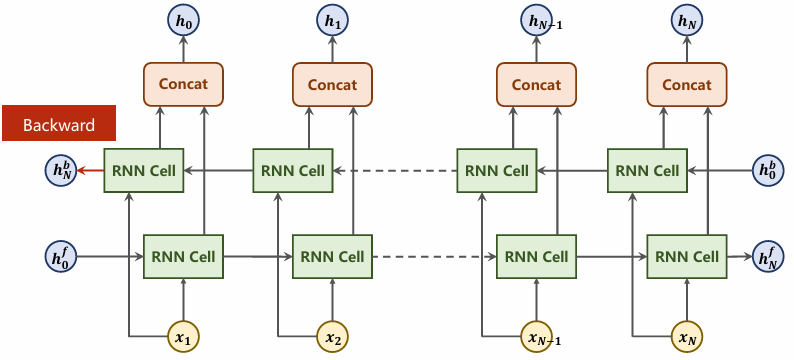
最终的输出是 。
4.2 代码实现
首先是处理数据读取部分,由于是读取文件的数据,使用 DataLoader 所以得在 datasets 包中,添加 NameDataset.py:
import csv
import gzip

from torch.utils.data import Dataset


class NameDataset(Dataset):
    def __init__(self, file_path: str) -> None:
        with gzip.open(file_path, "rt") as f:
            reader = csv.reader(f)
            rows = list(reader)

        self.names = [row[0] for row in rows] # 第一列
        self.len = len(self.names)
        self.country_raws = [row[1] for row in rows] # 第二列
        self.country_list = list(sorted(set(self.country_raws)))
        # 构成分类
        self.country_class = self.getCountryDict()
        self.country_count = len(self.country_list)

    def __getitem__(self, index):
        return self.names[index], self.country_class[self.country_raws[index]]

    def __len__(self):
        return self.len

    def getCountryDict(self):
        country_class_dict = dict()
        for idx, country_name in enumerate(self.country_list, 0):
            country_class_dict[country_name] = idx
        return country_class_dict

    def idx2country(self, idx):
        return self.country_list[idx]

    def getCountryCount(self):
        return self.country_count
然后在 models 包中,创建一个 RNNClassifier.py 文件:
from torch import nn
from torch.nn.utils.rnn import pack_padded_sequence
import torch

class RNNClassifier(nn.Module):
    def __init__(self, input_size, hidden_size, output_size, n_layers = 1, bidirectional = True) -> None:
        super(RNNClassifier, self).__init__()
        self.n_layers = n_layers # RNN Cell 层数
        self.input_size = input_size
        self.hidden_size = hidden_size
        # 双向还是单向
        self.n_directions = 2 if bidirectional else 1

        self.embedding = nn.Embedding(self.input_size, self.hidden_size)
        # 使用 GRU 神经网络
        self.gru = nn.GRU(
            self.hidden_size,
            self.hidden_size, self.n_layers,
            bidirectional=bidirectional
        )
        self.linear = nn.Linear(self.hidden_size*self.n_directions, self.output_size)

    def __init__hidden(self, batch_size):
        hidden = torch.zeros(
            self.n_layers * self.n_directions,
            batch_size,
            self.hidden_size
        )
        return hidden

    def forward(self, inputs, seq_lenghts):
        # 转置,变成(seq_len, batch_size)
        inputs = inputs.t()
        # 获取 batch_size
        batch_size = inputs.size(1)

        # 获取 h0
        hidden = self.__init__hidden(batch_size)
        # 获取经过嵌入层的结果
        emb = self.embedding(inputs)

        # 转化为 PackedSequence
        gru_inputs = pack_padded_sequence(emb, seq_lenghts)

        output, hidden = self.gru(gru_inputs, hidden)

        # 如果是双向的,需要拼接输出,否则直接输出
        if self.n_directions == 2:
            hidden_cat = torch.cat([hidden[-1], hidden[2]], dim=1)
        else:
            hidden_cat = hidden[-1]

        # 再用线性模型处理一次
        linear_output = self.linear(hidden_cat)
        return linear_output
最后在与 models 同级的包中,添加 main.py:
import torch
from datasets.NameDataset import NameDataset
from models.RNNClassifier import RNNClassifier
from torch.utils.data import DataLoader

# 将 name 字符串转化 char 数组
def name2charlist(name):
    name_char_list = [ord(c) for c in name]
    return (name_char_list, len(name_char_list))

# 将输入和输出转化为张量
def make_tensors(names, countries):
    # 获取字符+长度序列
    seqs_and_lens = [name2charlist(name) for name in names]
    # 构建字符序列集
    name_seqs = [sl[0] for sl in seqs_and_lens]
    # 构建序列长度集
    name_seq_lens = torch.LongTensor([sl[1] for sl in seqs_and_lens])

    countries = countries.long()
    # 接下来是将序列集转化为张量集的过程
    # 先创建一个同样大小的零矩阵
    seq_tensor = torch.zeros(len(name_seqs), int(name_seq_lens.max().item())).long()
    # 遍历字符序列集和长度集
    for idx, (seq, seq_len) in enumerate(zip(name_seqs, name_seq_lens)):
        # 根据序列长度,在零矩阵上的相应位置,直接更新这个张量
        seq_tensor[idx, :seq_len] = torch.LongTensor(seq)

    # 下面是将张量集和分类集进行倒序排序
    name_seq_lens, perm_idx = name_seq_lens.sort(dim=0, descending=True)
    seq_tensor = seq_tensor[perm_idx]
    countries = countries[perm_idx]

    return seq_tensor, name_seq_lens, countries

# 单次训练
# 模式和之前一样,只不 model 多传一个 name_seq_lens
def train_one(
    epoch: int,
    train_loader: DataLoader,
    model: RNNClassifier,
    criterion: torch.nn.CrossEntropyLoss,
    optimizer: torch.optim.Adam,
):
    total_loss = 0
    for i, (names, countries) in enumerate(train_loader, 1):
        inputs, name_seq_lens, target = make_tensors(names, countries)

        output = model(inputs, name_seq_lens)
        loss = criterion(output, target)

        optimizer.zero_grad()
        loss.backward()

        optimizer.step()

        total_loss += loss.item()
        if i % 10 == 0:
            print(f"Epoch - {epoch}", end="")
            print(f"\tloss={total_loss / (i * len(inputs))}")
    return total_loss

# 单次测试
def test_one(testset: NameDataset, test_loader: DataLoader, model: RNNClassifier):
    correct = 0
    total = len(testset)
    print("Evaluating Trained Model...")

    with torch.no_grad():
        for i, (names, countries) in enumerate(test_loader, 1):
            inputs, name_seq_lens, target = make_tensors(names, countries)
            output = model(inputs, name_seq_lens)

            pred = output.max(dim=1, keepdim=True)[1]
            correct += pred.eq(target.view_as(pred)).sum().item()

        percent = "%.2f" % (100 * correct / total)
        print(f"Test set: Accuracy {correct} / {total} {percent} %")

    return correct / total

# 训练
def training():
    n_chars = 128
    n_layers = 2
    n_epoch = 20
    hidden_size = 100
    batch_size = 256

    # 加载数据集
    trainset = NameDataset("data/names_train.csv.gz")
    testset = NameDataset("data/names_test.csv.gz")
    train_loader = DataLoader(trainset, batch_size=batch_size, shuffle=True)
    test_loader = DataLoader(testset, batch_size=batch_size, shuffle=False)
    n_countries = trainset.getCountryCount()

    # 初始化模型、损失函数、优化器
    model = RNNClassifier(n_chars, hidden_size, n_countries, n_layers)
    criterion = torch.nn.CrossEntropyLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.001)

    print("Training for %d epochs..." % n_epoch)

    # 进行训练
    for epoch in range(1, n_epoch + 1):
        train_one(epoch, train_loader, model, criterion, optimizer)
        acc = test_one(testset, test_loader, model)


if __name__ == "__main__":
    training()
运行结果:
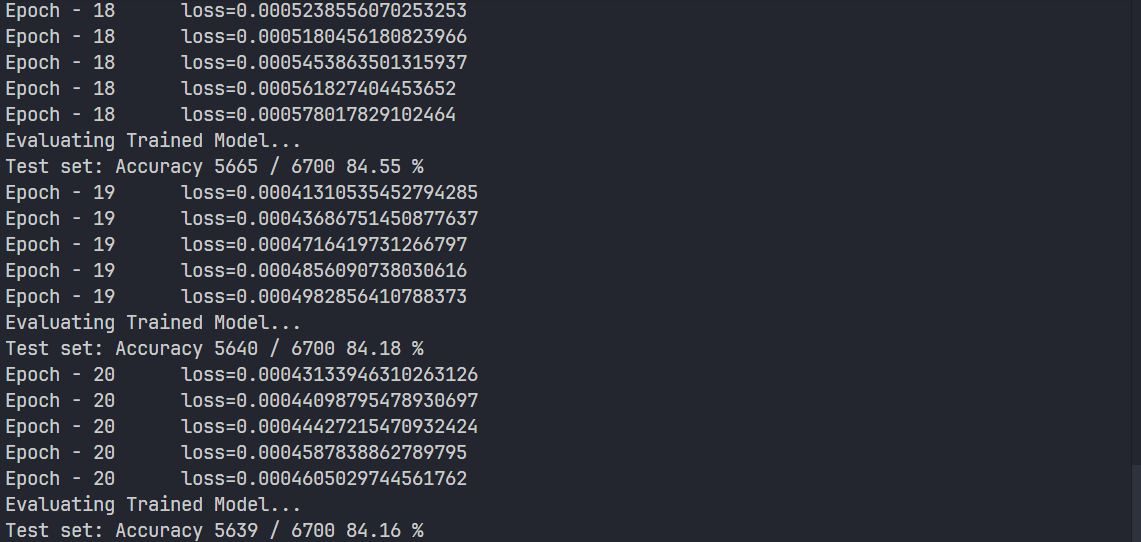
老师的好像到达了 0.85 ,我这里最高才 0.8474,后面就开始下降了。
4.3 复盘
- PackedSequence 的概念和作用
- 双向循环神经网络的概念与作用
- 双向循环神经网络的内部结构变化
- 处理字符串序列数据的大致思路
- 代码实现 GRU + RNN 分类器这种神经网络模型的大致思路。
5 说明
- 视频地址:《PyTorch深度学习实践》完结合集
- 我的笔记中的 demo 代码:NongXC_12-deeplearning_demo
0 人赞过
评论
评论加载中…