【学习笔记】刘二《PyTorch深度学习实践》- 1
1 线性模型
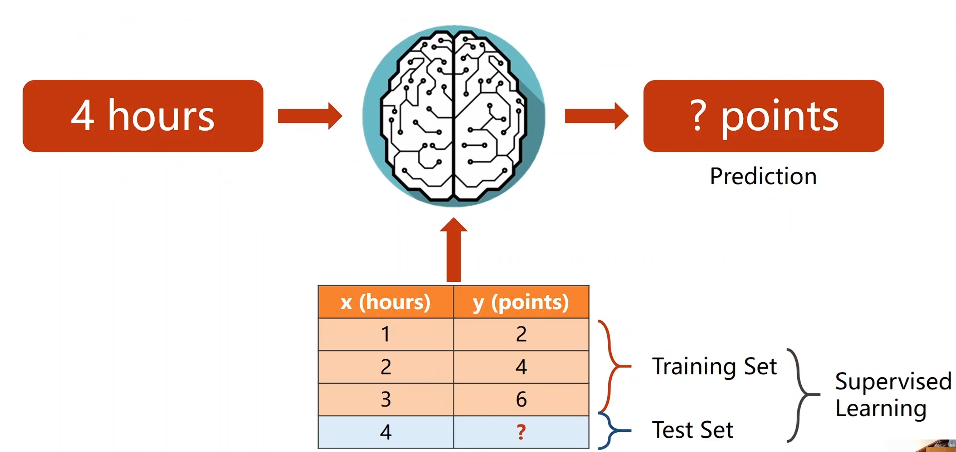
1.1 机器学习流程
机器学习的步骤要求:
- 获取数据集 DataSet
- 选择模型 Model
- 训练 Training
- 推理 Inferring
机器学习的通常步骤:
- 使用训练集训练模型
- 使用开发集(从训练集中划分出来)初步测试
- 使用测试集测试性能
- 得到最终的模型
- 输入新的数据给模型
- 得到预测结果
- 在训练时的拟合效果很好,但是在测试集却不是很好,可能是在训练时将噪声也进行识别了,导致过拟合。
- 在训练时的拟合效果很好,在测试集以及最终上线后,也能正确识别结果,说明模型具有很好的泛化能力。
1.2 线性回归模型学习
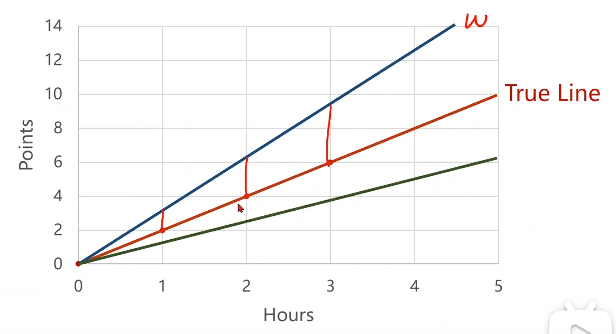
线性回归模型: 在模型训练中,对于需要计算实际值(预测值)与真实值之间的差距。对于线性回归模型来说,就是上面蓝色的线或者下面绿色的线,与中间红色的线的垂直高度差。单个样本的差距可以通过以下公式表示: 但为了在数学上便于求导和优化,通常来说,使用平方来代替绝对值,也就是叫做平方误差: 对于单个样本来说,这种函数称为模型的损失函数(Loss Function),针对的是单个样本。
对于包含了 N 个样本的整个训练集,通常取样本损失的平均值,称为均方误差(MSE ,Mean Square Error) ,也称为模型的成本函数(Cost Function): 我们通常通过一些算法让 Cost 尽可能小,不过这只是手段之一。最终目的是要让模型在未知的新数据上的误差尽可能小,也就是让模型的泛化能力更高。
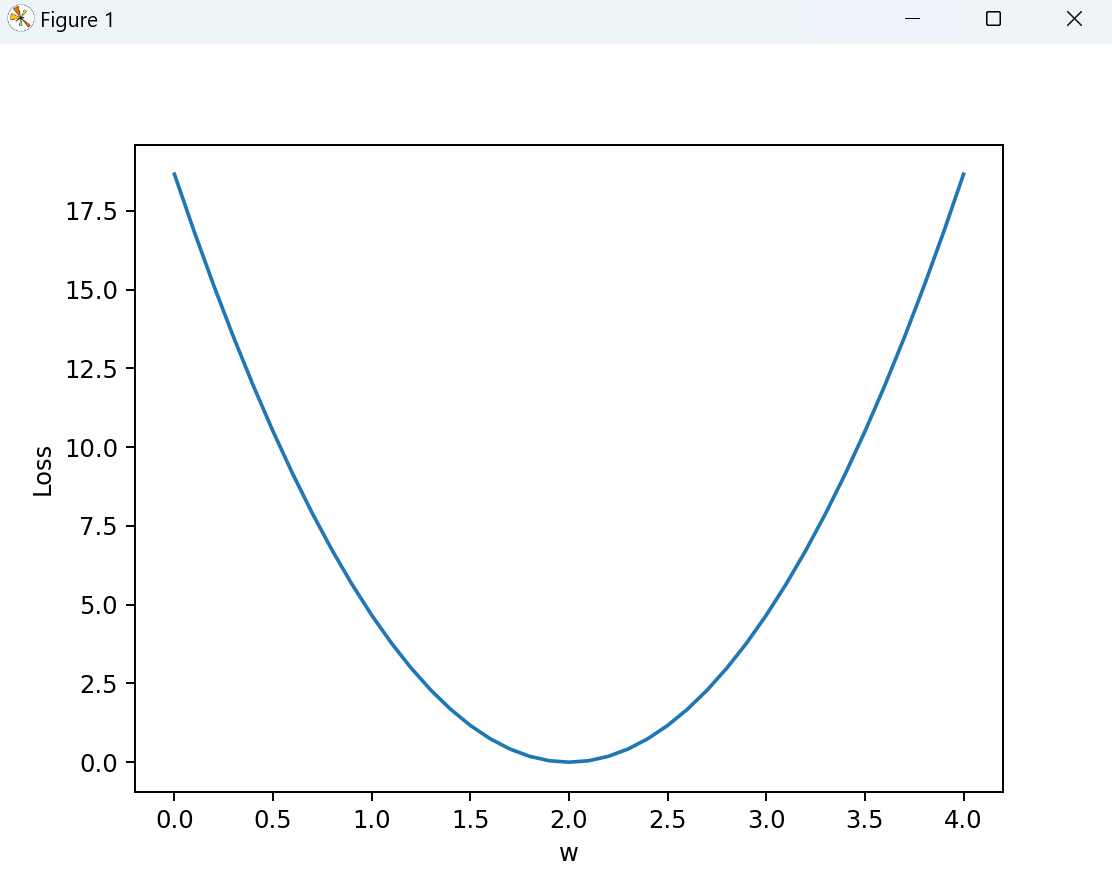
使用一段代码,简单的了解一下模型的训练过程,以及在线性回归模型中,未知权重参数与均值误差之间的关系。
import matplotlib.pyplot as plt
import numpy as np

# 训练集
x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]

# 线性回归模型,去掉了截距 b
def forward(x, w):
    return x * w

# 损失函数
def loss(y_pred, y):
    return (y_pred - y) * (y_pred - y)

# 调起的训练函数
def training():
    w_list = []
    mse_list = []

	# 设置权重 w 的范围(随机猜测)
    for w in np.arange(0.0, 4.1, 0.1):
        print(f"w = {w}")

		# 计算预测值与损失值
        los_sum = 0
        for x_val, y_val in zip(x_data, y_data):
            y_pred = forward(x_val, w)
            los_val = loss(y_pred, y_val)
            los_sum += los_val
            print(f"\t x = {x_val}, y = {y_val}, y_pred = {y_pred}, loss = {los_val}")

		# 计算该权重 wi 下的均方误差
        mse_val = los_sum / 3
        print(f"\t >>> MSE = {mse_val} \n")

		# 记录 wi 下的均方误差 mi
        w_list.append(w)
        mse_list.append(mse_val)

	# 绘制图
    plt.plot(w_list, mse_list)
    plt.ylabel("Loss")
    plt.xlabel("w")
    plt.show()


if __name__ == "__main__":
    training()
运行结果:
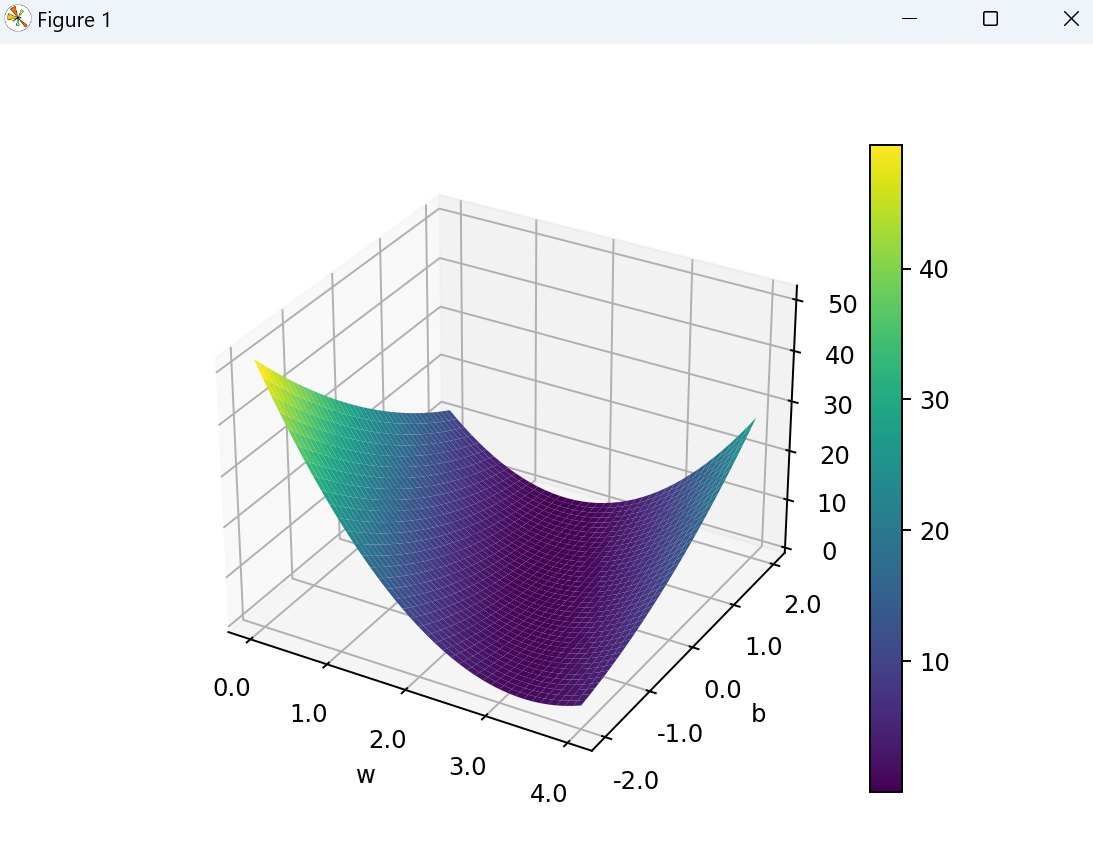
作业,基于完整线性回归模型: ,由于有两个未知参数,即权重 w 和截距 b,所以需要绘制权重 w 和截距 b 与成本函数 Cost 的关系图。
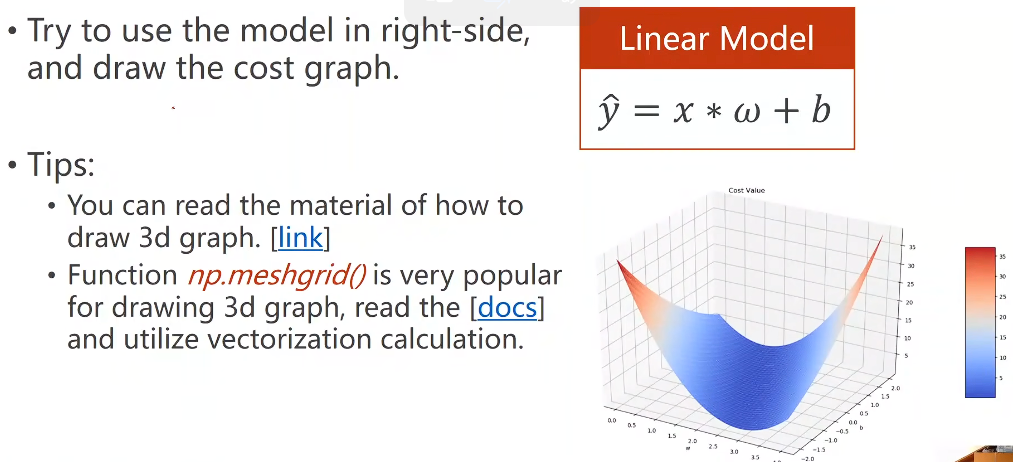
实现代码:
import matplotlib.pyplot as plt
import matplotlib.ticker as ticker
import numpy as np

# 训练集
x_data = [1.0, 2.0, 3.0]
y_data = [3.0, 5.0, 7.0]

# 线性回归模型
def forward(x, w, b):
    return x * w + b

# 损失函数
def loss(y_pred, y):
    return (y_pred - y) * (y_pred - y)

# 调起训练的方法
def training():
	# 定义权重 w 和截距 b 的范围
    w_list = np.arange(0.0, 4.1, 0.1)
    b_list = np.arange(-2.0, 2.1, 0.1)
    # 由于绘制需要一个二维矩阵,这里先定义出来
    mse_matrix = np.zeros((len(b_list), len(w_list)))

	# 计算 MSE
    for i in range(len(b_list)):
	    # 获取 bi
        b_val = b_list[i]
        print(f"b = {b_val}")

		# 获取 wj
        for j in range(len(w_list)):
            w_val = w_list[j]
            print(f"    w = {w_val}")

			# 计算在 bi 和 wj 下的损失值
            los_sum = 0
            for x_val, y_val in zip(x_data, y_data):
                y_pred = forward(x_val, w_val, b_val)
                los_val = loss(y_pred, y_val)
                los_sum += los_val
			# 计算并记录在 bi 和 wj 下的 MSE
            mse_matrix[i, j] = los_sum / 3

	# 通过 meshgrid 方法,将权重 w 和截距 b 变成二维坐标点
	# 就是将行 w 和列 b,w 作为行向量,复制扩展成 len(b_list) 行的二维矩阵 X
	# b 作为列向量,复制扩展成 len(w_list) 列的二维矩阵 Y
	# 这样,它们对应位置(X[i, j], Y[i, j])就对应参数集合(w_list[j], b_list[i])
	# 就是相应的二维平面坐标点
    X, Y = np.meshgrid(w_list, b_list)
    # 之前用 mse_matrix[i, j] = los_sum / 3
    # 也是通过坐标方式,定位和记录相应点的 MSE
    # 这些这么做都是为了下面的绘图需要
    Z = mse_matrix

	# 绘制 3d 曲面图
    fig = plt.figure()
    ax = fig.add_subplot(projection="3d")
    ax.xaxis.set_major_formatter(ticker.FormatStrFormatter("%.1f"))
    ax.yaxis.set_major_formatter(ticker.FormatStrFormatter("%.1f"))

    surf = ax.plot_surface(X, Y, Z, cmap="viridis")
    fig.colorbar(surf)

    plt.xlabel("w")
    plt.ylabel("b")
    plt.show()

if __name__ == "__main__":
    training()
运行结果:
1.3 复盘
- 机器学习的基本过程和步骤。
- 训练集、开发集、测试集的各自作用。
- 过拟合、泛化能力的概念。
- 线性回归模型的公式。
- 线性回归模型的平方误差、均方误差公式。
- 损失函数、成本函数的概念和区别,以及其与模型训练的关系。
- 代码实现简要的模型训练流程,绘图查看位置参数与成本函数之间的关系。
2 梯度下降算法
2.1 基本梯度下降算法学习
权重参数的数量增多,搜索量会指数级增长,为了避免这种情况,使用分治法。
分治法的思路是,在初始时,划分区间,例如横轴四个区间,纵轴四个区间,那只要在这四个区间,找最小值的点。找到这个点以后,在这个点周围,继续划分区间,找这些区间的最小值,以此类推。
好处:能够减少计算量。
弊端:适用于光滑凸函数,但实际的权重参数与成本函数曲线不是光滑的,分治法可能会找到某个位置的最小值,而不是全局的最小值。并且实际的权重参数很多,不止一个,划分的区间可能很多,导致计算量突增。
梯度:成本函数(或损失函数)对权重参数的导数,梯度的公式: 由于导数就是切线斜率,并且我们希望成本函数的结果最小,所以我们必须往梯度递减的方向进行,也就是导数是负数的方向。梯度下降算法(GDA,Gradient Descent Algorithm)的基本公式: 其中 称为学习率。为了防止权重跳跃过大, 需要取很小的值。梯度下降算法使用了一种思想,就是只看眼前获益最大的结果,也就是贪心思想。
而贪心算法的弊端和分治法一样,不一定能找到全局最优点,可能会找到局部最优点。
这里需要了解一下凸函数:简单来说,在函数内,任意两点的连线,其线段的任意点,都在函数图像上方,那么这个函数就是凸函数。
非凸函数,其实就是不满足凸函数定义的,就是非凸函数,它可能是一个波浪形的曲线。
对于非凸函数,可能存在多个最低点(通常都是一阶导数为 0,二阶导数大于 0),这些最低点就是局部最优点。
在这个函数定义域中,如果没有一个局部最优点的函数值,比该点还小,这个点就是全局最优点。
有个很特殊的点,这个点的一阶导数为零,二阶导数可能是大于零,也可能是小于零。在三维上,这个点在某个切面上是最小值,而在零一个方向上的切面,却是最大值。这个特殊点叫做鞍点。
鞍点是比局部最优点更难解决的问题,因为其导数为 0,也就是梯度为 0,可能会导致梯度无法下降,训练无法继续。
接下来,使用梯度下降算法,推导之前的公式: 的梯度下降公式:
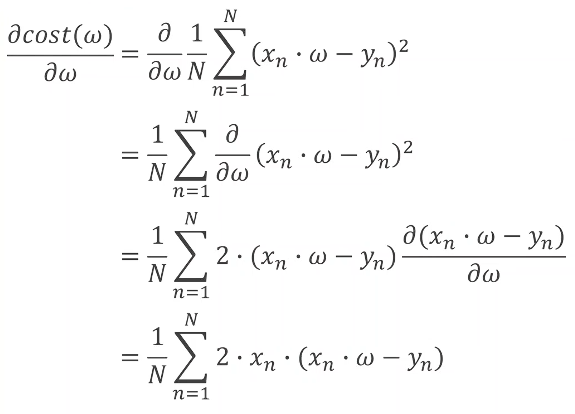
使用这个公式,编写一段利用梯度下降训练模型的基本代码:
# 训练集
x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]

# 线性回归模型
def forward(x, w):
    return x * w

# 成本函数
def cost(x_data, y_data, w):
    mse = 0
    for x_val, y_val in zip(x_data, y_data):
        y_pred = forward(x_val, w)
        loss = (y_pred - y_val) ** 2
        mse += loss

    return mse / len(x_data)

# 梯度计算
def gradient(x_data, y_data, w):
    w_grad = 0
    for x_val, y_val in zip(x_data, y_data):
        w_grad += 2 * x_val * (x_val * w - y_val)

    return w_grad / len(x_data)

# 训练
def training():
	# 确定预测值
    w = 1.0
    a = 0.01

	# 训练 100 轮
    for i in range(100):
	    # 计算成本(输出用)以及梯度
        cost_val = cost(x_data, y_data, w)
        grad_val = gradient(x_data, y_data, w)
		# 梯度下降
        w -= a * grad_val

        print(f"Epoch: {i}, w = {w:.6f}, cost = {cost_val:.6f}")
	# 测试模型最终结果
    print(f"Predict(after training) >>> input = 4, output = {forward(4, w):.6f}")


if __name__ == "__main__":
    training()
运行结果:
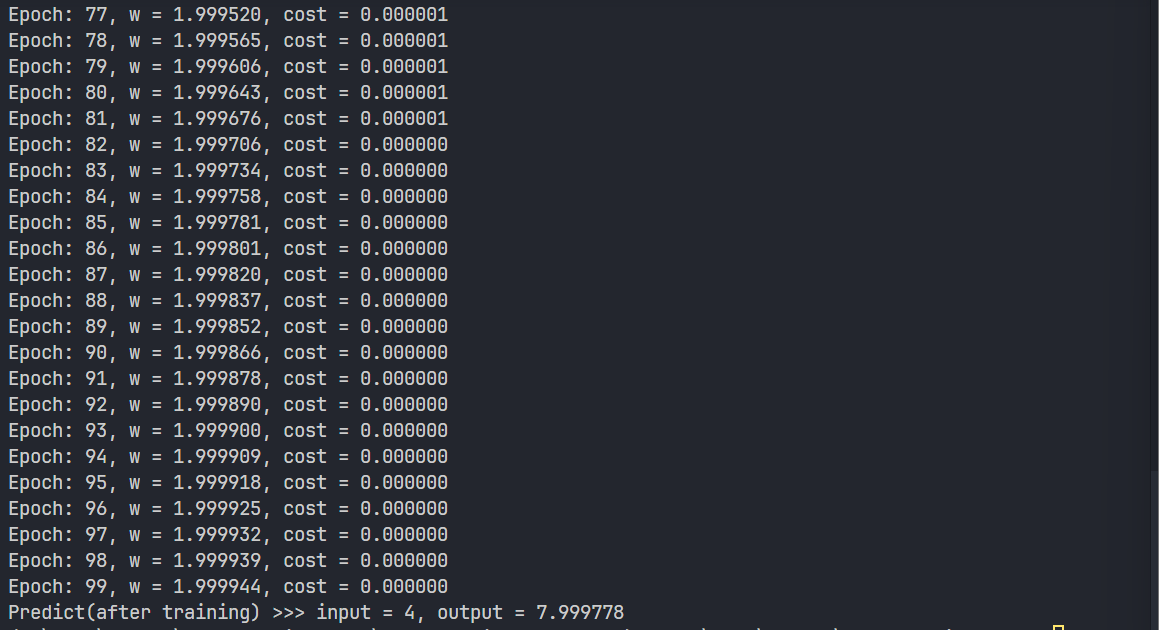
可以看到,100轮的训练,结果还略有偏差,把轮次加到 1000 轮看看:
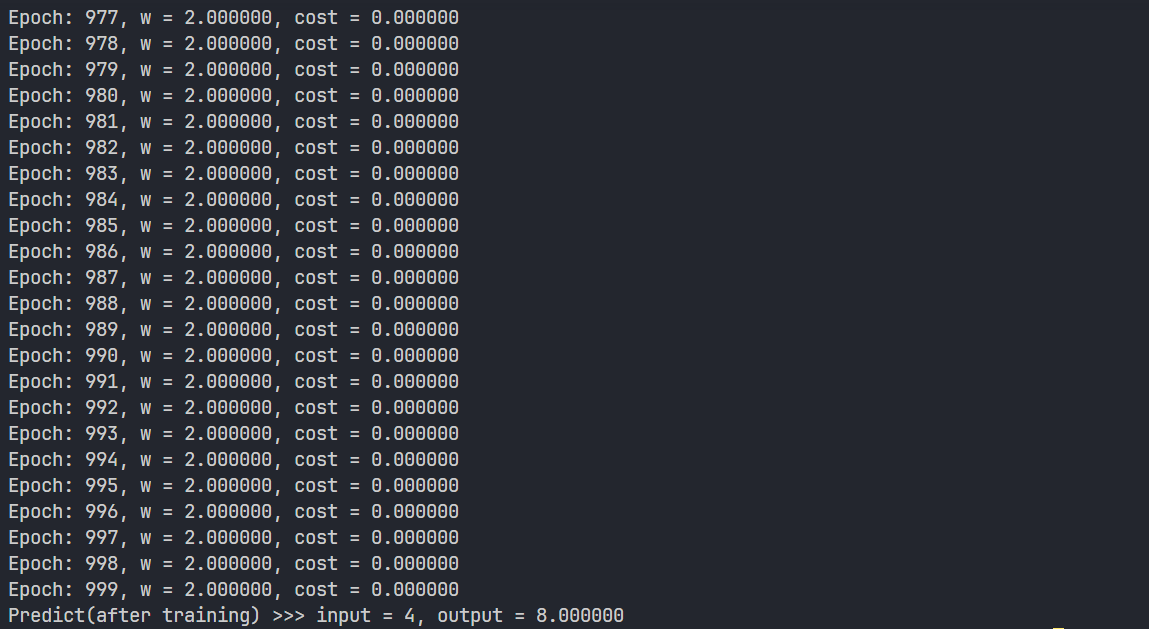
训练轮次还是模型最终性能有影响的。把轮次和成本的关系图绘制出来,更能直观的感受:
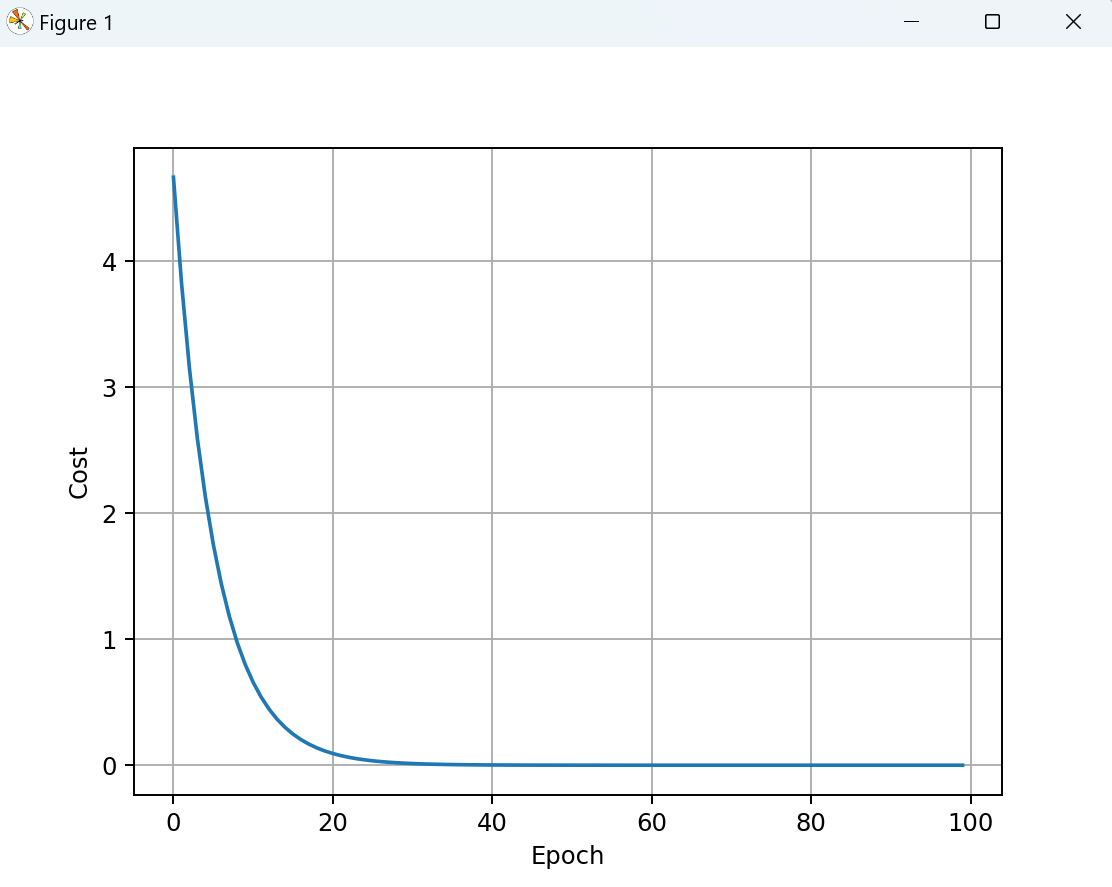
但是,实际的训练过程中,轮次与成本并不会是这样光滑的曲线,而是有摆动的,就像股票的线图一样,对于这样的先,我们可以用指数加权均值来平滑它: 其中, 指的是平均后的损失值。
2.2 随机梯度下降算法学习
上述的梯度下降,取的是所有成本的平均损失,而随机梯度下降(SGD,Stochastic Gradient Descent)的思路是,从提供的 N 个样本中,随机选择一个样本的损失,对权重求导更新。基本的公式是:
由于只使用一个样本,所以不需要累加求平均,对于之前的线性回归模型,其梯度公式变成了: 接下来,继续使用代码实现,使用随机梯度下降的方法进行模型训练。由于本身数据量小,就不做真正随机了,使用顺序执行。
# 数据集
x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]

# 线性回归模型
def forward(x, w):
    return x * w

# 损失函数(由于只计算单个样本,不需要使用均方误差)
def loss(x, y, w):
    y_pred = forward(x, w)
    return (y_pred - y) ** 2

# 梯度计算
def gradient(x, y, w):
    return 2 * x * (x * w - y)

# 训练
def training():
	# 预测权重
    w = 1.0
    a = 0.01

    # 训练 100 轮
    for i in range(100):
	    # 随机取样(由于数据量小,这里就顺序取样)
        for x_val, y_val in zip(x_data, y_data):
	        # 计算损失值(打印用)
            loss_val = loss(x_val, y_val, w)
            # 计算梯度
            grad_val = gradient(x_val, y_val, w)

			# 梯度下降
            w -= a * grad_val

            print(f"Epoch: {i}, w = {w:.6f}, cost = {loss_val:.6f}")

	# 测试模型最终结果
    print(f"Predict(after training) >>> input = 4, output = {forward(4, w):.6f}")

if __name__ == "__main__":
    training()
运行结果:
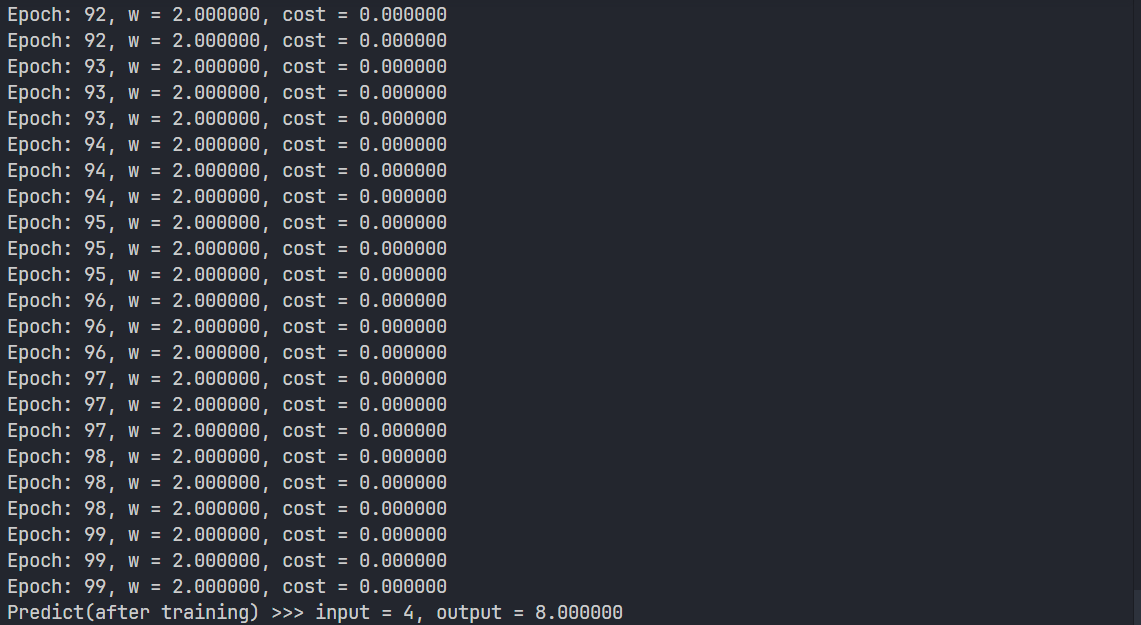
这用 100 轮就达到了之前 1000 轮的效果,优势还是很明显的,这里将损失与轮次的关系图绘制一下:
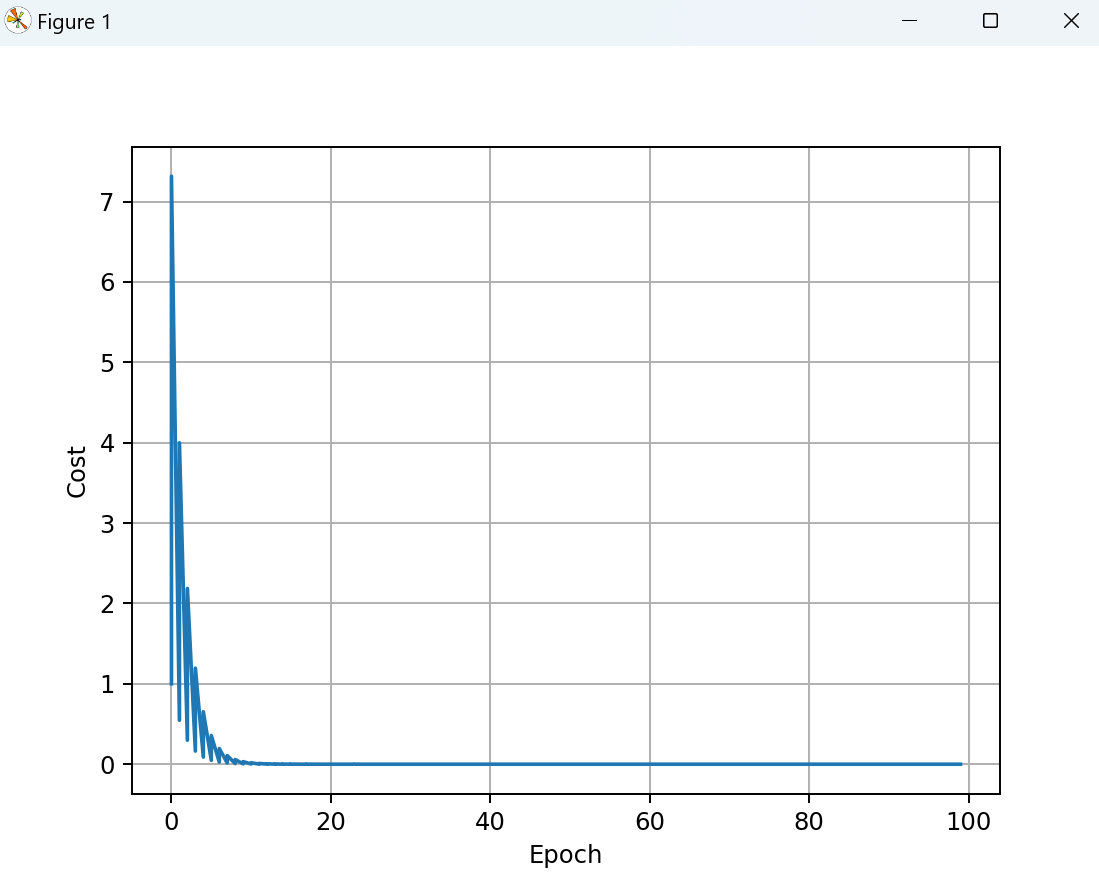
可以看到,这里的图出现了锯齿,主要原因是在训练时,对于每一轮,都做了三次取样,进行了三次梯度下降,所以导致一轮出现三个损失值。这里尝试使用指数加权均值平滑一下,当然,更好的做法是将这三次损失值做平均,作为该轮的损失值:
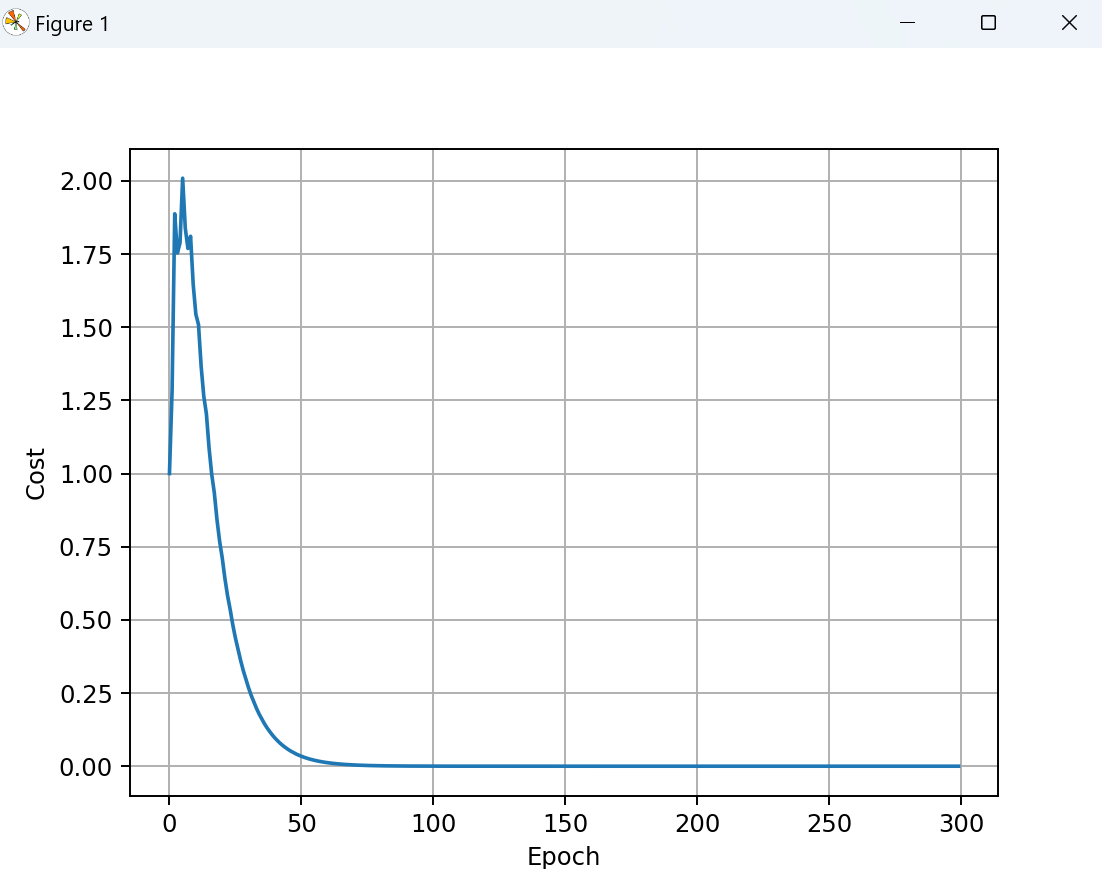
平滑代码:
def smooth(loss_list):
    c_list = []
    c_list.append(loss_list[0])
    beta = 0.1

    for i in range(len(loss_list)):
        if i > 0:
            c_current = beta * loss_list[i] + (1 - beta) * c_list[i - 1]
            c_list.append(c_current)
    return c_list
2.3 两个梯度下降算法的比较
基础的梯度下降算法是这样的: 随机梯度下降算法是这样的: 区别在于,基础的梯度下降使用成本函数,针对整个样本损失值,求和取均值,作为需要求导的原函数;而随机梯度下降算法针对的是单个随机取样的样本,使用损失函数计算单个样本的损失值,作为需要求导的原函数。
在实际训练时,由于梯度下降是针对整个样本的损失值,计算的是整个样本的均方误差,所以在计算梯度时,我们可以将多个样本的梯度计算,并行执行,然后将最终结果汇总计算平均,提高运行效率,减少运行时间。在此之后,就可以使用这个梯度,计算新的权重,继续下一轮训练。
而随机梯度是针对单个随机取样到的样点,虽然计算梯度是独立的,但在计算权重时,你需要知道上一个权重的值。而上一个权重的值,是由上一个随机取样点计算出来的。也就是说,随机取样中,每个权重的计算是串行的,是有依赖关系的,所以是不能并行执行的。这就使得随机梯度在样本量大的情况下的时间复杂度更高。
从之前的代码运行中可以看到了,随机梯度在达到最优解时,使用的轮次少,性能高;而梯度下降使用的轮次多,性能低。但在实际大样本量计算时,由于随机梯度不可并行,计算的时间复杂度更高,而可并行的梯度下降的时间复杂度会相对低。
为了解决这个问题,就采用了一种介于两者之间的方案,叫做 Mini-Batch。Mini-Batch 的思路就是,将若干个样本作为一组,作为一个 Batch,进行梯度计算。
机器学习中 SGD (随机梯度下降),默认就是 Mini-Batch 方案。
2.4 复盘
- 基本的梯度下降算法公式
- 随机梯度下降算法公式
- 指数加权均值公式
- 两个梯度下降算法的比较。
- Mini-Batch 的思路。
3 反向传播
3.1 计算图、正向传播与反向传播
我们前面学习的线性回归模型,是一个非常基础简单的模型,只有一两个权重参数,可以轻松的推导出相应的损失函数和梯度。
但是在实际训练过程中,模型的权重参数不止有一两个,有非常非常多的权重参数。假设输入 x 是一个 m 维的向量,输出 y 是一个 n 维的向量,用简单的线性回归模型: ,我们的 就需要是一个 m x n 维的矩阵,就可能需要计算 m x n 个权重参数。
如果对于每个权重参数,我们都一个个写解析式,求导求梯度,难度非常非常大。
所以,这里就学习一个名为反向传播的思路,将每个神经网络节点当作是一个原子计算操作(计算图),可以正向求出损失值后,反向得出梯度并传递过来,不需要写繁琐的解析式。
对于一个两层的神经网络,其计算图如图右侧所示。
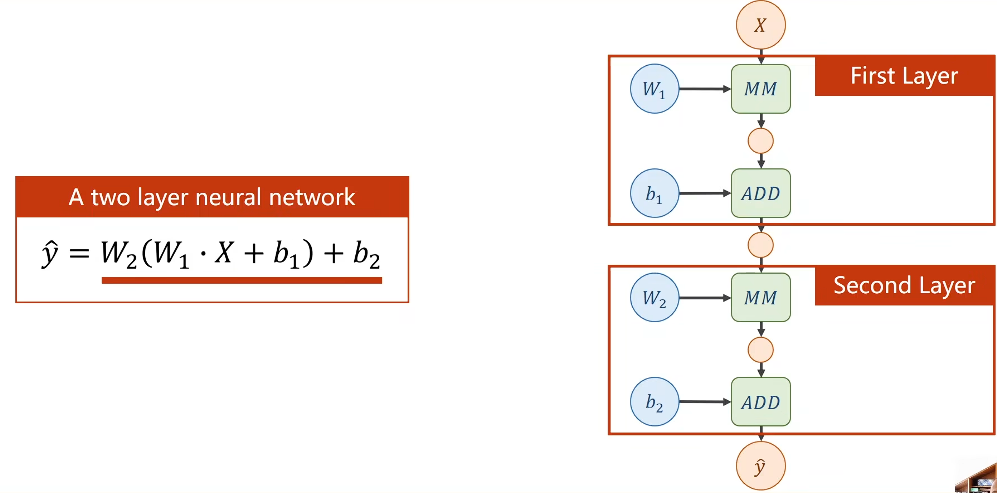
x 是输入,y 是输出,w 和 b 都是权重参数。MM 是矩阵乘法,ADD 是矩阵加法,中间的空心圆表示中间结果。
后续的正向传播,反向传播都是以计算图为基础,其计算过程如下图所示:
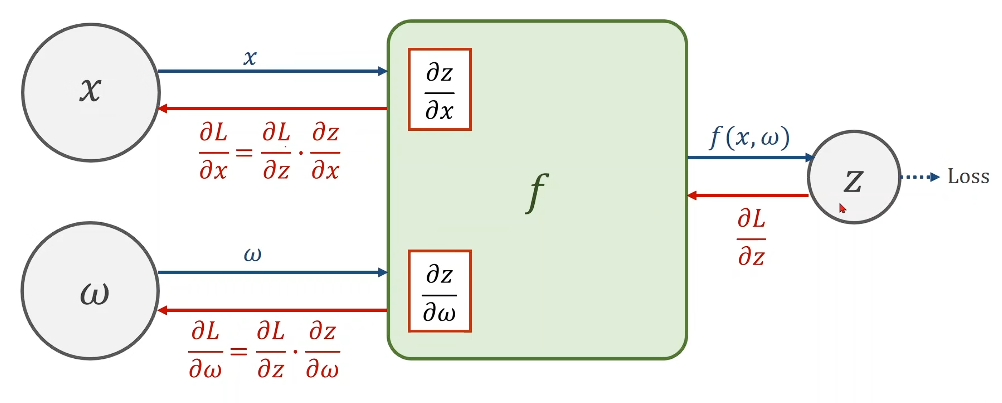
从图中,我们可以明确两个信息:
- 正向传播(蓝色箭头方向)的主要目的是计算模型的预期输出以及误差。通过预期输出,传递给损失函数后,就可以得到损失值,或者说误差值。
- 反向传播(红色箭头方向)的主要目的是更新权重,通过计算损失函数与预期输出值的偏导数,也称输出的梯度。然后逐步计算局部梯度,得到最终梯度,最终通过梯度来更新权重。
也就是说:
- 正向传播,传递方向是: ,目的是算误差。
- 反向传播,传递方向是: ,目的是更新权重。
模型通过这两个过程的交替进行,每次正向传播算出损失,反向传播更新权重,反复循环直到模型的损失收敛到最小。
正向传播,依赖于解析式,例如上述的线性回归模型,输入值得出预期输出,并传递给损失函数计算误差。
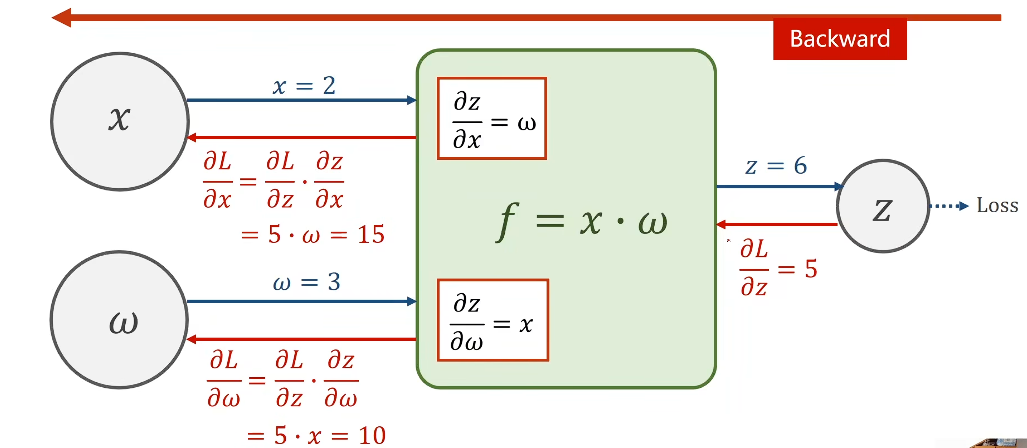
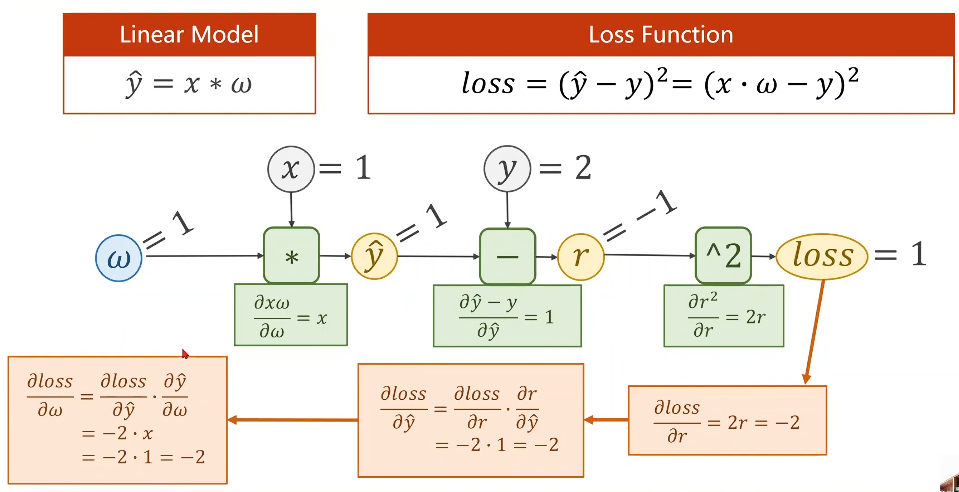
反向传播,依赖的就是损失函数和解析式,因为计算梯度需要知道损失函数(或成本函数)与权重参数的导数:。而我们反向传播的过程,就是在通过预期输出 z 以及导数的链式法则,计算出这个导数:
代入值,就是这样的:
更加详细的计算过程:
我们来计算下面这个练习题:
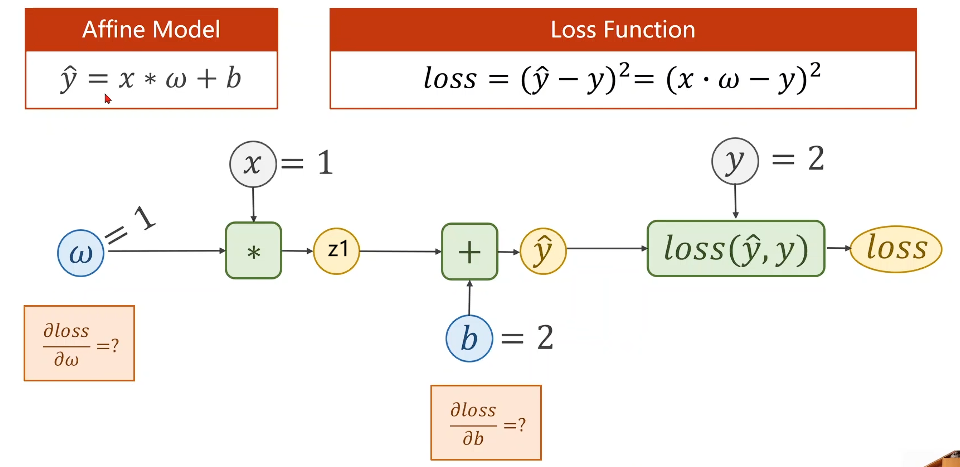
- 正向传播
- 第一步:,所以 为 1,导数: 。
- 第二步: ,所以 ,导数: 、 。
- 第三步: ,所以 ,导数:。
- 反向传播
- 第一步:计算 对 的导数:。
- 第二步:计算 对 的导数: ,所以 。
- 第三步:计算 对 的导数:。
- 第四步:计算 对 的导数:。所以 。
结果是 2,2 。
3.2 代码实现
这里使用 PyTorch 来进行正向反向传播的使用。
在进行代码编写之前,先要学习 PyTorch 的基础组件,张量(Torch)。
Torch 是一个类,用于动态构建计算图,它包含两个很重要的属性,就是权重参数和梯度(损失函数对权重的导数)。
所以 Torch 在构建计算图,执行反向传播的时候,其权重的修改和梯度都保存在当前的 Torch 中。
下面是基于线性回归模型,利用正向传播、反向传播来训练模型的代码:
import torch

# 数据集
x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]

# 正向传播的线性回归模型
def forward(x, w) -> torch.Tensor:
    return x * w

# 损失函数
def loss(x, y, w) -> torch.Tensor:
    y_pred = forward(x, w)
    return (y_pred - y) ** 2

# 训练
def training():
	# 定义张量
    w = torch.Tensor([1.0])
    # 这里要启用梯度计算
    w.requires_grad = True
    a = 0.01

	# 进行 100 轮训练
    for epoch in range(100):
        print("Epoch-", epoch)

        # 进行权重更新
        for x_val, y_val in zip(x_data, y_data):
	        # 利用损失值和反向传播计算梯度
            loss_val = loss(x_val, y_val, w)
            loss_val.backward()

			# 更新梯度
            w.data -= a * w.grad.data # type: ignore

			# 我们不需要梯度累加,所以更新权重后要将梯度清零
            w.grad.data.zero_() # type: ignore

        print("\t w = ", w.item())
	# 进行预测,判断模型训练结果
    print(f"Predict: x = 4, y = {forward(4, w).item()}")


if __name__ == "__main__":
    training()
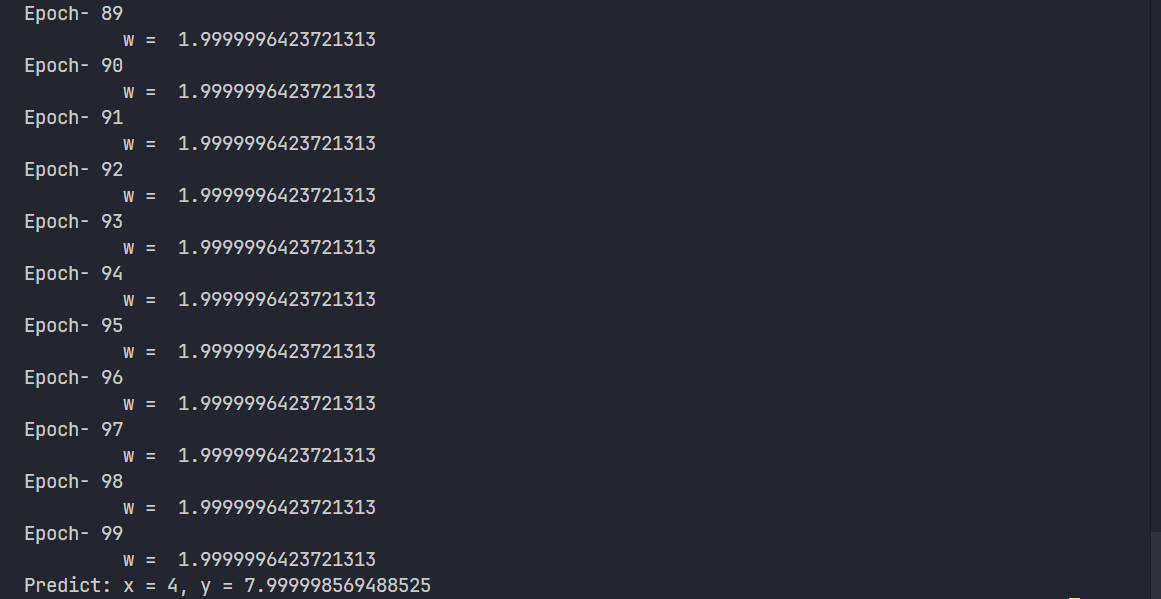
由于 w 是张量,并且 Torch 是用于动态构建计算图的,所以我们的
forward函数和loss函数,其运算符会被重载为张量计算。由于进行的是张量计算,所以x * w、(y_pred - y) ** 2本质上不是在进行张量值的计算,而是在构建计算图。需要计算 w 的梯度,就需要利用计算图进行反向传播,于是调用了
loss_val.backward(),就能得到 w 的梯度。当看见张量之间进行运算符运算时,请不要认为是数值计算,它们是在构建计算图。你的脑中要自动的联想出这个计算式的计算图。
从代码中,还可以看到,在获取张量值时,既有用
.data,也有用.item(),其实最好的做法是用.item()。.data用于更新,而.item()用于获取。
运行结果:
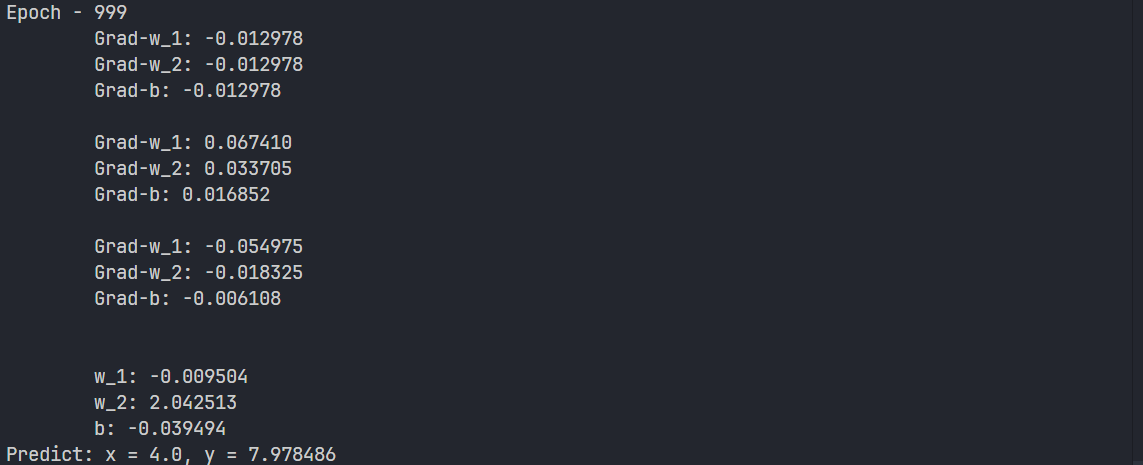
接下来,我们做下面这个练习,训练集使用上述的训练集:
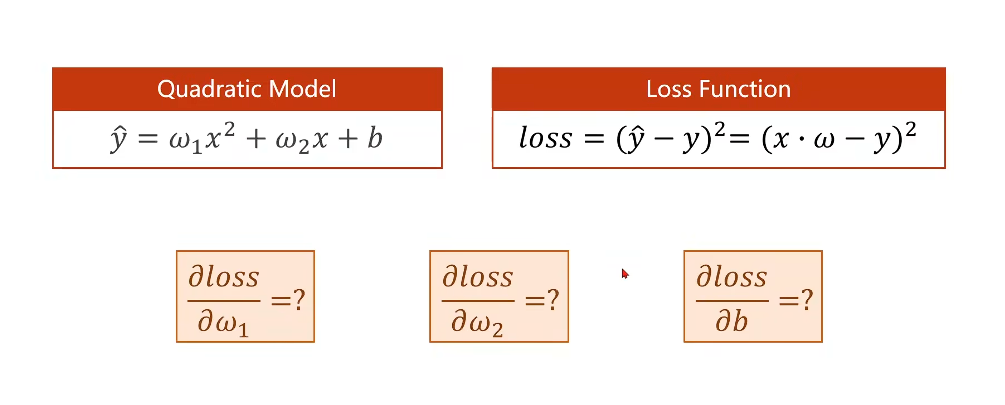
代码:
from torch import Tensor

# 训练集
x_data = [1.0, 2.0, 3.0]
y_data = [2.0, 4.0, 6.0]

# 模型
def forward(x: float, w_1: Tensor, w_2: Tensor, b: Tensor) -> Tensor:
    return w_1 * (x**2) + w_2 * x + b

# 损失函数
def loss(x: float, y: float, w_1: Tensor, w_2: Tensor, b: Tensor) -> Tensor:
    y_pred = forward(x, w_1, w_2, b)
    return (y_pred - y) ** 2

# 更新权重的方法
def updateWeight(des: Tensor, a: float) -> Tensor:
    return des.data - a * des.grad.data  # type: ignore

# 训练
def training():
	# 猜测权重值
    w_1 = Tensor([-1.0])
    w_2 = Tensor([1.0])
    b = Tensor([-1.0])
    a = 0.01

    w_1.requires_grad = True
    w_2.requires_grad = True
    b.requires_grad = True

	# 训练 1000 轮
    for epoch in range(1000):
        print(f"Epoch - {epoch}")

		# 更新权重
        for x_val, y_val in zip(x_data, y_data):
	        # 构建计算图,反向传播
            loss_val = loss(x_val, y_val, w_1, w_2, b)
            loss_val.backward()

			# 更新权重
            w_1.data = updateWeight(w_1, a)
            w_2.data = updateWeight(w_2, a)
            b.data = updateWeight(b, a)

            print(f"\tGrad-w_1: {w_1.grad.data.item():.6f}")  # type: ignore
            print(f"\tGrad-w_2: {w_2.grad.data.item():.6f}")  # type: ignore
            print(f"\tGrad-b: {b.grad.data.item():.6f} \n")  # type: ignore

			# 清空梯度
            w_1.grad.data.zero_()  # type: ignore
            w_2.grad.data.zero_()  # type: ignore
            b.grad.data.zero_()  # type: ignore

        print(f"\n\tw_1: {w_1.item():.6f}")
        print(f"\tw_2: {w_2.item():.6f}")
        print(f"\tb: {b.item():.6f}")

	# 预测新输入
    print(f"Predict: x = 4.0, y = {forward(4.0, w_1, w_2, b).item():.6f}")


if __name__ == "__main__":
    training()
运行结果:
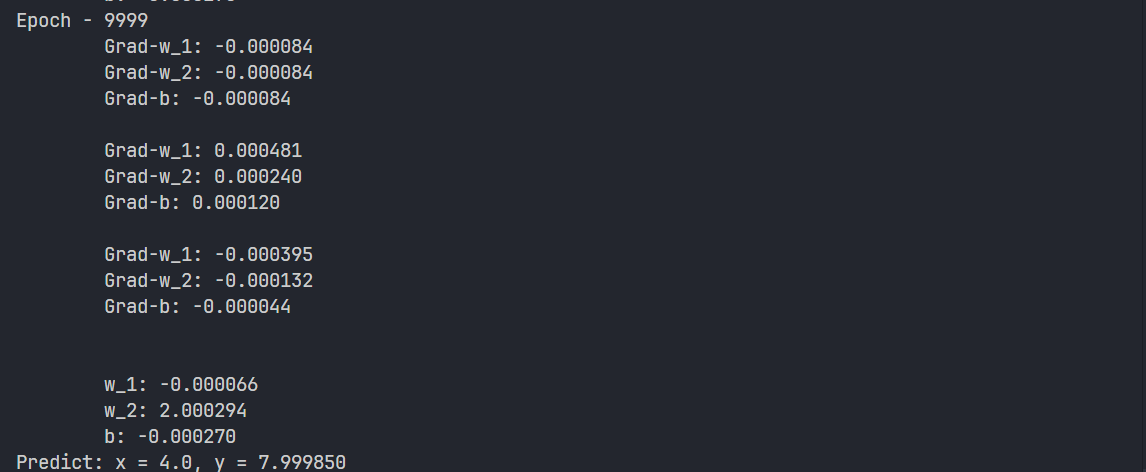
我们把轮次增大到 10000 轮:
3.3 复盘
- 计算图、正向传播、反向传播的关系与设计目的。
- 以线性回归模型为例,正向传播与反向传播的计算过程。
- PyTorch 张量(Torch)的两个重要属性
- 在 PyTorch 使用正向传播、反向传播训练模型的方法
4 PyTorch 实现线性回归
4.1 前置说明
在进行代码实现前,需要知道我们的目标是什么。
我们的目标就是基于线性回归模型,利用 PyTorch 进行模型训练,或者说权重更新。
在 1.1 中,说明了机器学习的四个主要步骤要求:
- 获取数据集 DataSet
- 选择模型 Model
- 训练 Training
- 推理 Inferring
现在的模型训练,也是基于这四个要求,只不过需要进行一些修改:
- 准备数据集
- 设计模型
- 构建损失函数和优化器
- 训练
- 推理
在之前的代码实现中,使用的数据集都是数组形式。但是在 PyTorch 中,基本的运算都是使用 Torch 进行。
所以,在 PyTorch 中,我们需要将思路从普通的数组运算,转向线性代数,我们要以标量、向量、矩阵的思路进行运算。
张量、向量、数组之间有什么关系?
- 标量(Scalar):0 维数组。比如 1、2、3 这种单独的数字。
- 向量(Vector):1 维数组。一列数,比如
[1, 2, 3, 4],形状是(4,)。- 矩阵(Matrix):2 维数组。一张表格,有行有列,形状类似
(3, 4)。- 张量(Tensor):3 维以上的数组,所有高维数据的统称,形状类似
(2, 3, 4)。所以说,向量是 1 维的张量,矩阵是 2 维的张量,张量是它们的通用说法,而数组则是它们在计算机上的表示方式。
怎么转向线性代数呢?其实就是要把我们的训练集,看成一个 3 x 1 的矩阵。而线性回归模型的公式是这样的: 已知输入 x 和输出 y 都是 3 x 1 的矩阵,那 和 是什么矩阵?没错, 需要是一个 3 x 3 的矩阵,而 需要是一个 3 x 1 的矩阵。
在其他教材中,可能会将线性回归模型的公式变成如下两个样子: 这两个的区别很简单,当 和 是一个 m x n 的矩阵,对于第一个公式, 就是需要是一个 n x n 的矩阵,而 b 需要是 m x n 的矩阵;对于第二个公式,其实是教材默认将 和 做了转置,变成了 n x m 的矩阵,所以 就需要做一个转置。
无论它们是什么样子,最终的目的都是让输入参数和输出结果的维度保持一致。
此外,我们还需要理解 PyTorch 中的广播机制。例如 a 是一个 3 x 1 的矩阵,b 是一个 1 x 2 的矩阵,在进行 a + b 等运算时,PyTorch 会自动将 b 的每一行复制,变成 3 x 2 矩阵进行运算。
4.2 代码实现
把思路拉回到我们的目的:基于线性回归模型,利用 PyTorch 进行模型训练,或者说权重更新。
需要进行以下几个步骤:
- 准备数据集 对于数据的准备,目前暂时没有学到,就以之前的三个数据为训练集。
- 设计模型 在 PyTorch 中,我们不需要手动求导算梯度,我们的目的是根据模型,构造出模型的计算图。
- 构建损失函数和优化器 在 PyTorch 中,可以使用其提供的 API 来直接构建损失函数(SGD)和优化器(权重更新)。
- 训练 确定好训练轮次,利用 PyTorch 的正向传播和反向传播进行权重更新,实现模型训练。
- 推理验证 提供一个新的输入给模型,让其求出预期结果,验证训练效果。
代码如下: 创建一个 models 包,创建一个 LinearModel.py 文件:
from torch import nn


class LinearModel(nn.Module):
    def __init__(self) -> None:
        super(LinearModel, self).__init__()
        self.linear = nn.Linear(1, 1)

	# 这里手动重写了 forward 函数
    def forward(self, x):
        y_pred = self.linear(x)
        return y_pred
和 models 包同级,创建一个 main.py 文件:
from models.LinearModel import LinearModel
from torch import Tensor, nn, optim

# 训练集
x_data = Tensor([[1.0], [2.0], [3.0]])
y_data = Tensor([[2.0], [4.0], [6.0]])

# 训练方法
def training():
	# 准备模型
    model = LinearModel()
	# 使用 MES 损失函数
    criterion = nn.MSELoss(size_average=False)
    # 使用 SGD 更新权重
    optimizer = optim.SGD(model.parameters(), lr=0.01)

	# 训练 1000 轮
    for epoch in range(1000):
	    # 计算预测值
        y_pred = model(x_data)
	    # 计算损失
        loss = criterion(y_pred, y_data)
        print(f"Epoch - {epoch}, loss = {loss.item():.10f}")

		# 清空梯度
        optimizer.zero_grad()
	    # 反向传播
        loss.backward()
        # 更新权重
        optimizer.step()

    print(f"w = {model.linear.weight.item():.10f}")
    print(f"b = {model.linear.bias.item():.10f}")

	# 提供新输入给模型,测试训练效果
    x_test = Tensor([[4.0]])
    print(f"Predict: x = 4.0, y = {model(x_test).data}")


if __name__ == "__main__":
    training()
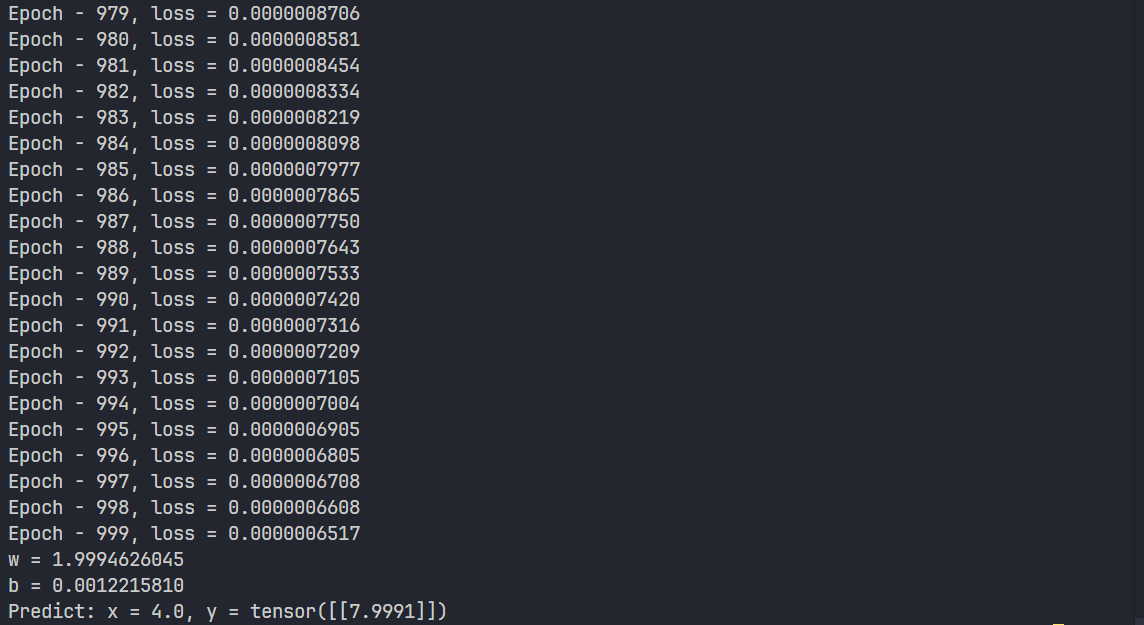
运行结果:
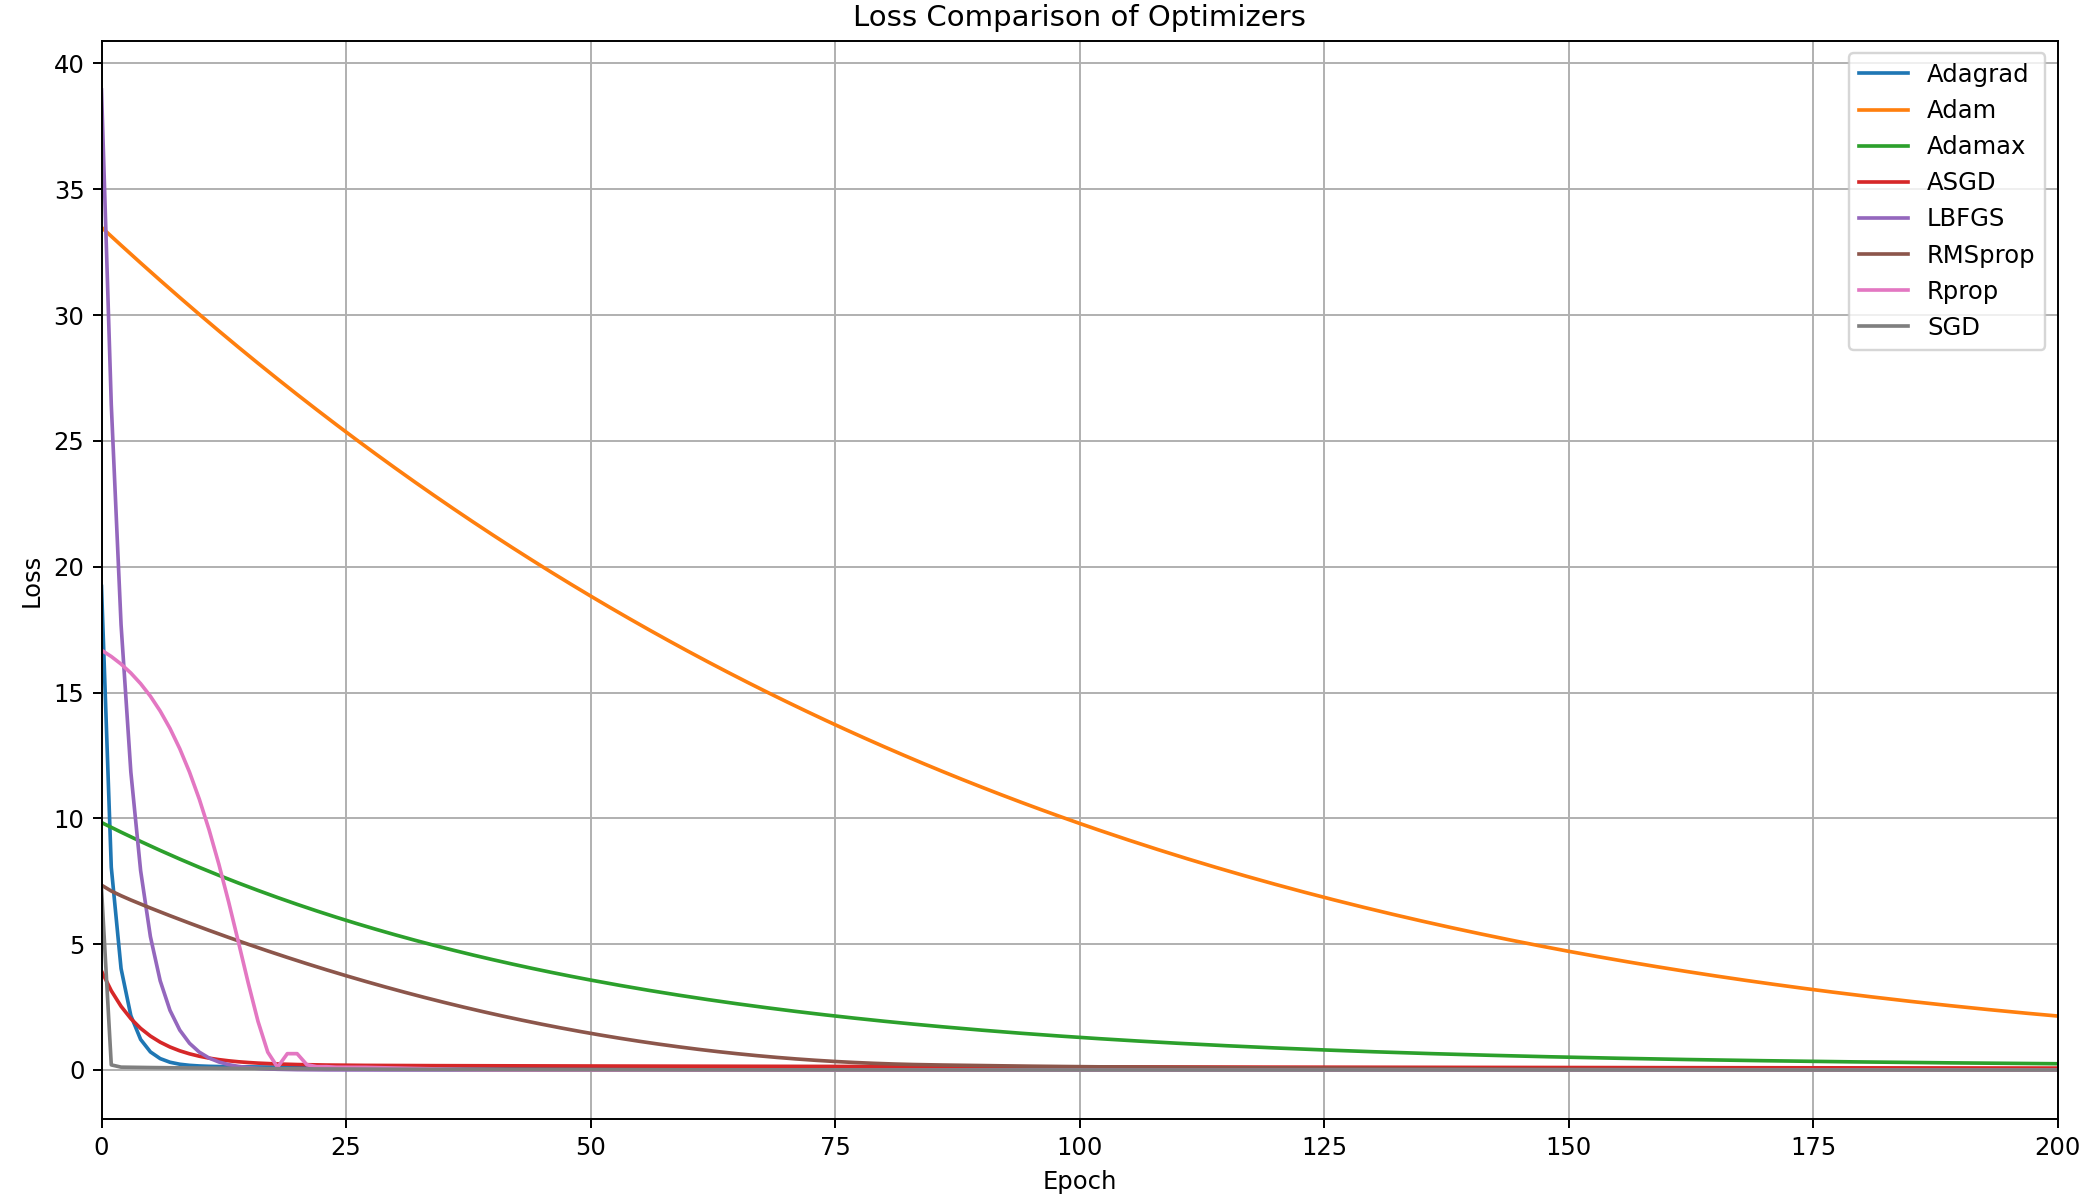
这里还有一个任务,就是 PyTorch 提供了很多个优化器:Adagrad、 Adam、 Adamax、 ASGD、 LBFGS、 RMSprop、 Rprop、 SGD。为了观察它们的性能,我们绘制它们的损失和训练轮次的曲线。
和 main.py 同级,新增一个 optim_compare.py 文件:
import matplotlib.pyplot as plt
from models.LinearModel import LinearModel
from torch import Tensor, nn, optim

x_data = Tensor([[1.0], [2.0], [3.0]])
y_data = Tensor([[2.0], [4.0], [6.0]])
optimizer_names = [
    "Adagrad",
    "Adam",
    "Adamax",
    "ASGD",
    "LBFGS",
    "RMSprop",
    "Rprop",
    "SGD",
]


def getOptimizer(index: int, model: LinearModel):
    optimizers = [
        optim.Adagrad(model.parameters(), lr=0.5),
        optim.Adam(model.parameters(), lr=0.01, betas=(0.5, 0.999)),
        optim.Adamax(model.parameters(), lr=0.01, betas=(0.5, 0.999)),
        optim.ASGD(model.parameters(), lr=0.01),
        optim.LBFGS(model.parameters(), lr=0.01),
        optim.RMSprop(model.parameters(), lr=0.01, alpha=0.5),
        optim.Rprop(model.parameters(), lr=0.01),
        optim.SGD(model.parameters(), lr=0.1),
    ]

    return optimizers[index]


def training(optimizer, model: LinearModel) -> dict:
    criterion = nn.MSELoss()
    epoch_list, loss_list = [], []

    for epoch in range(2000):
        if isinstance(optimizer, optim.LBFGS):

            def closure():
                optimizer.zero_grad()
                y_pred = model(x_data)
                loss = criterion(y_pred, y_data)
                loss.backward()
                return loss

            loss = optimizer.step(closure)
        else:
            y_pred = model(x_data)
            loss = criterion(y_pred, y_data)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

        epoch_list.append(epoch)
        loss_list.append(loss.item())  # type: ignore

    print(
        f"Weight: {model.linear.weight.data.item():.4f}, Bias: {model.linear.bias.data.item():.4f}"
    )

    x_test = Tensor([[4.0]])
    print(f"Predict: x = 4.0, y = {model(x_test).data}")
    return {"epoch": epoch_list, "loss": loss_list}


def compare():
    plt.figure(figsize=(15, 8))

    for index in range(8):
        model = LinearModel()
        result = training(getOptimizer(index, model), model)

        plt.plot(result["epoch"], result["loss"], label=optimizer_names[index])

    plt.legend(loc="best")
    plt.title("Loss Comparison of Optimizers")
    plt.xlabel("Epoch")
    plt.ylabel("Loss")
    plt.grid(True)
    plt.xlim(0, 200)

    plt.show()


if __name__ == "__main__":
    compare()
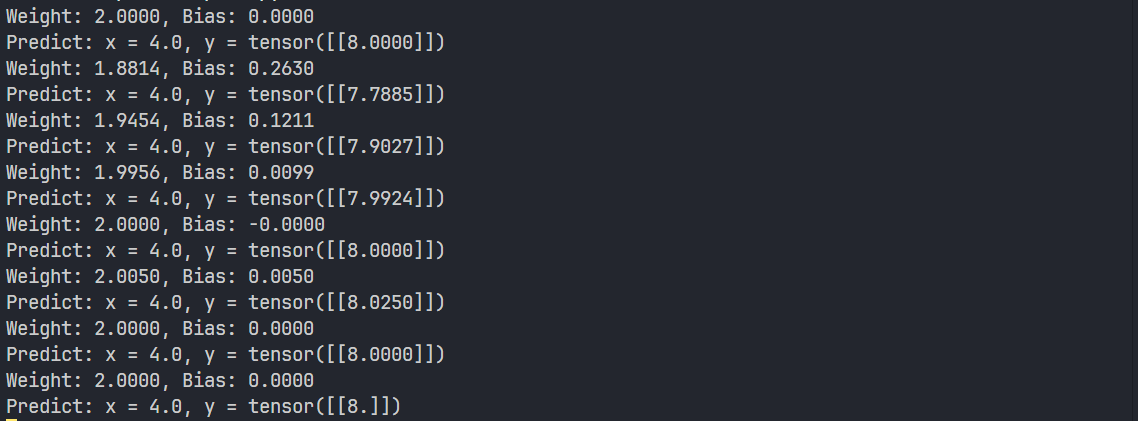
我将一些优化器的初始化参数,调整到了最终的预测值,大致接近真实值的样子,所以每个优化器的初始化参数可能不同。 训练轮次均是 2000 轮,绘制图表时只会绘制前 200 轮。
运行结果:
绘制出的曲线图:
4.3 复盘
- 使用 PyTorch 实现线性回归的步骤。
- 张量、向量、矩阵、数组之间的区别。
- 代码实现使用 PyTorch 实现线性回归的大致思路。
5 说明
- 视频地址:《PyTorch深度学习实践》完结合集
- 我的笔记中的 demo 代码:NongXC_12-deeplearning_demo
0 人赞过
评论
评论加载中…