Python 实现基础的串行步骤任务机制
1 前言
哎呀,最近有点忙,有一段时间没看博客了,好在都运行得好好的。不愧是我花了大心思编写的项目哈哈哈(其实我知道是因为没什么人来看,扎心了老铁)
前段时间我在学习 Python 时,遇到过一个问题,我有一个串行的流程,大概就是:爬取数据 -> 清洗数据 -> 保存数据的这么个流程。
但是由于这个流程完整执行的话耗时很长,一个接一个执行的话十分缓慢,我就想着能不能做一个简单的任务机制,将这段流程打包成一个任务,然后并发执行。
单纯的并发其实好解决,就弄个线程池,一个一个启动不就行了。
但是我要的是任务机制,可以记录这个流程中,各个步骤点的执行状态,并且支持暂停、继续、重新开始等等进阶功能。
除此之外,我还希望这个功能有一个基本的排队能力,不然我批量启动的话,如果超过线程池的线程用完了,剩下的就启动失败,这不太行。
应该是如果没有线程可用,就等待,等到有线程池了,再启动。
于是编写完这个需求,就着手编写了一个简单的原型 demo,接下来简单说说实现的思路。
2 基础功能实现
所谓的基础功能,就是实现一个简单的并发任务启动机制,搭建好框架。
目标很简单:
- 实现任务功能,每个任务可以按固定流程串行执行爬取数据 -> 清洗数据 -> 保存数据的这么个流程。
- 可以创建多个任务,并且多个任务同时执行。
首先,当然是定义实体类数据模型。
我的思路很简单,外层是一个任务,任务包含:任务 id 、任务状态、执行信息(或者说记录错误的信息)以及各个步骤;内层就是实际的步骤了,包括步骤执行顺序、步骤 id (这个暂时没有用,但先定义着)、步骤状态、执行信息。
也就是说,整个流程:爬取数据 -> 清洗数据 -> 保存数据,每个流程点,是一个具体的步骤,这几个完整的步骤串行执行,就是完整的任务。
from dataclasses import dataclass
from entity.TaskStatus import TaskStatus

@dataclass
class TaskStep:
    step_id: str
    step_order: int
    step_status: TaskStatus
    step_message: str
from dataclasses import dataclass
from typing import Dict
from entity.TaskStep import TaskStep

@dataclass
class Task:
    task_id: str
    task_steps: Dict[str, TaskStep]
    task_status: str
    task_message: str
步骤状态:
from enum import Enum

class TaskStatus(str, Enum):
    PENDING = "PENDING"
    RUNNING = "RUNNING"
    WAITING = "WAITING"
    COMPLETED = "COMPLETED"
    FAILED = "FAILED"
由于我需要步骤直接能够顺序传递一些信息,这里我就添加一个上下文类,专门用于存储上下文直接的信息
from dataclasses import dataclass
from typing import Any

@dataclass
class TaskContext:
    content: Any
基本的数据类型定义完成了,但是可以发现,这些只是用于记录任务和步骤执行状态的实体类,而不是真正的处理逻辑。
那处理逻辑怎么写呢?我有三个步骤,每个步骤都是不同的操作,怎么统一描述呢?
这个说法是不是很熟悉?其实这种说法就是面向对象的三大特性之一,多态。我们可以用接口来抽象这些逻辑。
from abc import ABC, abstractmethod
from typing import Optional

from entity.Task import Task
from entity.TaskContext import TaskContext


class ITaskStepHandler(ABC):

    @abstractmethod
    def execute(
        self, task: Task, step_order: int, context: Optional[TaskContext]
    ) -> TaskContext:
        pass
我把三个流程点的类都顺便给出: 爬取数据:
import random
import time
import uuid
from typing import Optional

from entity.Task import Task
from entity.TaskContext import TaskContext
from interface.ITaskStepHandler import ITaskStepHandler


class FetchDataStepHandler(ITaskStepHandler):
    def execute(
        self, task: Task, step_order: int, context: Optional[TaskContext]
    ) -> TaskContext:

        print("Fetching data...")
        time.sleep(random.uniform(3, 5))

        data = {
            "id": str(uuid.uuid4()),
            "name": f"user_{str(uuid.uuid4().hex[:8])}",
            "age": random.randint(18, 30),
            "gender": random.choice(["male", "female"]),
        }

        return TaskContext(
            content=data,
        )
清洗数据:
import random
import time
import uuid
from typing import Optional

from entity.Task import Task
from entity.TaskContext import TaskContext
from interface.ITaskStepHandler import ITaskStepHandler


class CleanDataStepHandler(ITaskStepHandler):
    def execute(
        self, task: Task, step_order: int, context: Optional[TaskContext]
    ) -> TaskContext:
        if context is None:
            raise Exception("Context is None")

        print("Cleaning data...")
        time.sleep(random.uniform(3, 5))

        data = context.content
        data["description"] = str(uuid.uuid4().hex)

        return TaskContext(
            content=data,
        )
保存数据:
import json
import time
from typing import Optional

from entity.Task import Task
from entity.TaskContext import TaskContext
from interface.ITaskStepHandler import ITaskStepHandler


class SaveDataStepHandler(ITaskStepHandler):
    def execute(
        self, task: Task, step_order: int, context: Optional[TaskContext]
    ) -> TaskContext:
        if context is None:
            raise Exception("Context is None")

        print("Saveing data...")
        time.sleep(4)

        with open(f"temp/{task.task_id}.json", "w") as f:
            f.write(json.dumps(context.content, indent=4, ensure_ascii=False))

        return TaskContext(
            content=None,
        )
现在,步骤处理器定义好了(后续统一称 StepHandler),但是,目前的 StepHandler 和 Task 没有关系。
换句话说,现在的 Task,只记录着 TaskStep 的状态,也就是 TaskStep,但是它不知道这些 TaskStep,具体需要使用哪些 StepHandler 。
所以,我们还得维护一个 Map,将步骤的处理顺序,和具体的 StepHandler 映射,这样,只要知道这个 TaskStep 的 step_order 是哪个,Task 就知道调用哪个具体的 StepHandler 进行处理。
from handler.step_handler.CleanDataStep import CleanDataStepHandler
from handler.step_handler.FetchDataStepHandler import FetchDataStepHandler
from handler.step_handler.SaveDataStepHandler import SaveDataStepHandler
from interface.ITaskStepHandler import ITaskStepHandler


class TaskStepHandlerManager:
    TASK_STEP_HANDLERS_MAP = {
        "1": FetchDataStepHandler(),
        "2": CleanDataStepHandler(),
        "3": SaveDataStepHandler(),
    }

    @staticmethod
    def get_hanler_by_step_order(step_order: int) -> ITaskStepHandler:
        step_handler = TaskStepHandlerManager.TASK_STEP_HANDLERS_MAP.get(
            str(step_order)
        )
        if step_handler is None:
            raise Exception(f"Step handler not found for step order {step_order}")

        return step_handler
实体类用于记录信息,处理器类用于执行处理步骤,那怎么把这两个类结合起来?使其变成能处理 + 记录的完整任务?
我们沿用定义任务和步骤的思路,外层的任务,那自然是需要一个任务执行器(TaskExecutor),来执行任务,而具体的步骤,我们就用步骤执行器(TaskStepExecutor)来执行。
from typing import Optional

from loguru import logger

from entity.Task import Task
from entity.TaskContext import TaskContext
from entity.TaskStatus import TaskStatus
from executor.TaskStepExecutor import TaskStepExecutor


class TaskExecutor:
    @staticmethod
    def execute_task(task: Task):
        try:
            task.task_status = TaskStatus.RUNNING
            logger.info(f"Task {task.task_id} runnning")

            task_context: Optional[TaskContext] = None
            for step_order in task.task_steps.keys():
                task_context = TaskStepExecutor.execute_step(
                    task, int(step_order), task_context
                )

            logger.info(f"Task {task.task_id} completed")

        except Exception as e:
            logger.error(f"Task {task.task_id} failed: {e}")

            task.task_status = TaskStatus.FAILED
            task.task_message = str(e)
from typing import Optional

from loguru import logger

from entity.Task import Task
from entity.TaskContext import TaskContext
from entity.TaskStatus import TaskStatus
from manager.TaskStepHandlerManager import TaskStepHandlerManager


class TaskStepExecutor:
    @staticmethod
    def execute_step(
        task: Task, step_order: int, context: Optional[TaskContext]
    ) -> TaskContext:
        try:
            task.task_steps[str(step_order)].step_status = TaskStatus.RUNNING
            logger.info(f"task: {task.task_id} step: {step_order} runnning")

            step_handler = TaskStepHandlerManager.get_hanler_by_step_order(step_order)
            context = step_handler.execute(task, step_order, context)

            task.task_steps[str(step_order)].step_status = TaskStatus.COMPLETED
            logger.info(f"task: {task.task_id} step: {step_order} completed")

            return context

        except Exception as e:
            logger.error(f"task: {task.task_id} step: {step_order} failed, reason: {e}")

            task.task_steps[str(step_order)].step_status = TaskStatus.FAILED
            task.task_steps[str(step_order)].step_message = str(e)
            raise
这样,当一个 Task 创建时,就交给 TaskExecutor,TaskExecutor 在合适的时机,记录任务的状态,并调用 TaskStepExecutor,处理所有步骤;而 TaskStepExecutor ,接收任务和步骤处理顺序,基于处理器和处理顺序的 Map,执行具体的 StepHandler,并在合适的时机,记录步骤的状态。
这样,就巧妙的将记录状态的实体类、记录具体处理逻辑的处理器类结合起来,实现了一个完整的任务。
为了方便创建任务,我额外编写一个专门负责创建空白 Task 的类
import uuid

from entity.Task import Task
from entity.TaskStatus import TaskStatus
from entity.TaskStep import TaskStep


class TaskMainPipeline:

    @staticmethod
    def build_main_pipeline() -> Task:
        return Task(
            task_id=str(uuid.uuid4()),
            task_steps={
                "1": TaskStep(
                    step_id="1",
                    step_order=1,
                    step_status=TaskStatus.PENDING,
                    step_message="",
                ),
                "2": TaskStep(
                    step_id="2",
                    step_order=2,
                    step_status=TaskStatus.PENDING,
                    step_message="",
                ),
                "3": TaskStep(
                    step_id="3",
                    step_order=3,
                    step_status=TaskStatus.PENDING,
                    step_message="",
                ),
            },
            task_status=TaskStatus.PENDING,
            task_message="",
        )
接下来,就是解决并发问题了。非常简单,只需要创建一个线程池,然后将任务执行交给线程池就行。这个流程可以专门封装一个类。
from concurrent.futures import Future, ThreadPoolExecutor
from typing import Dict

from loguru import logger

from entity.Task import Task
from executor.TaskExecutor import TaskExecutor


class TaskConcurrencyManager:
    def __init__(self, max_worker: int = 5):
        self.executor = ThreadPoolExecutor(max_worker)
        self.running_tasks: Dict[str, Future] = {}

    def run_task(self, task: Task) -> None:
        try:
	        # 调用任务执行器,执任务
            TaskExecutor.execute_task(task)
        except Exception as e:
            logger.error(f"Run task {task.task_id} failed: {e}")
            raise

    def on_task_complete(self, task_id: str, future: Future) -> None:
        if task_id in self.running_tasks:
            del self.running_tasks[task_id]

        try:
            future.result()
        except Exception as e:
            logger.error(f"complete Task {task_id} failed: {e}")
            raise

    def submit_task(self, task: Task) -> None:
        if task.task_id in self.running_tasks:
            logger.warning(f"Task {task.task_id} is already running")
            return

        if len(self.running_tasks) >= self.executor._max_workers:
            logger.warning("Max worker reached, wait for task to complete")
            return

		# 将任务提交到线程池
        future = self.executor.submit(self.run_task, task)
        self.running_tasks[task.task_id] = future

        future.add_done_callback(
            lambda future: self.on_task_complete(task.task_id, future)
        )

        logger.success(f"Submit task {task.task_id}")
再写一个简单的 main 文件,执行一下:
from manager.TaskConcurrencyManager import TaskConcurrencyManager
from pipeline.TaskMainPipeline import TaskMainPipeline


def run() -> None:
    task_concurrency_manager = TaskConcurrencyManager(max_worker=5)

    for i in range(4):
        task = TaskMainPipeline.build_main_pipeline()
        task_concurrency_manager.submit_task(task=task)


if __name__ == "__main__":
    run()
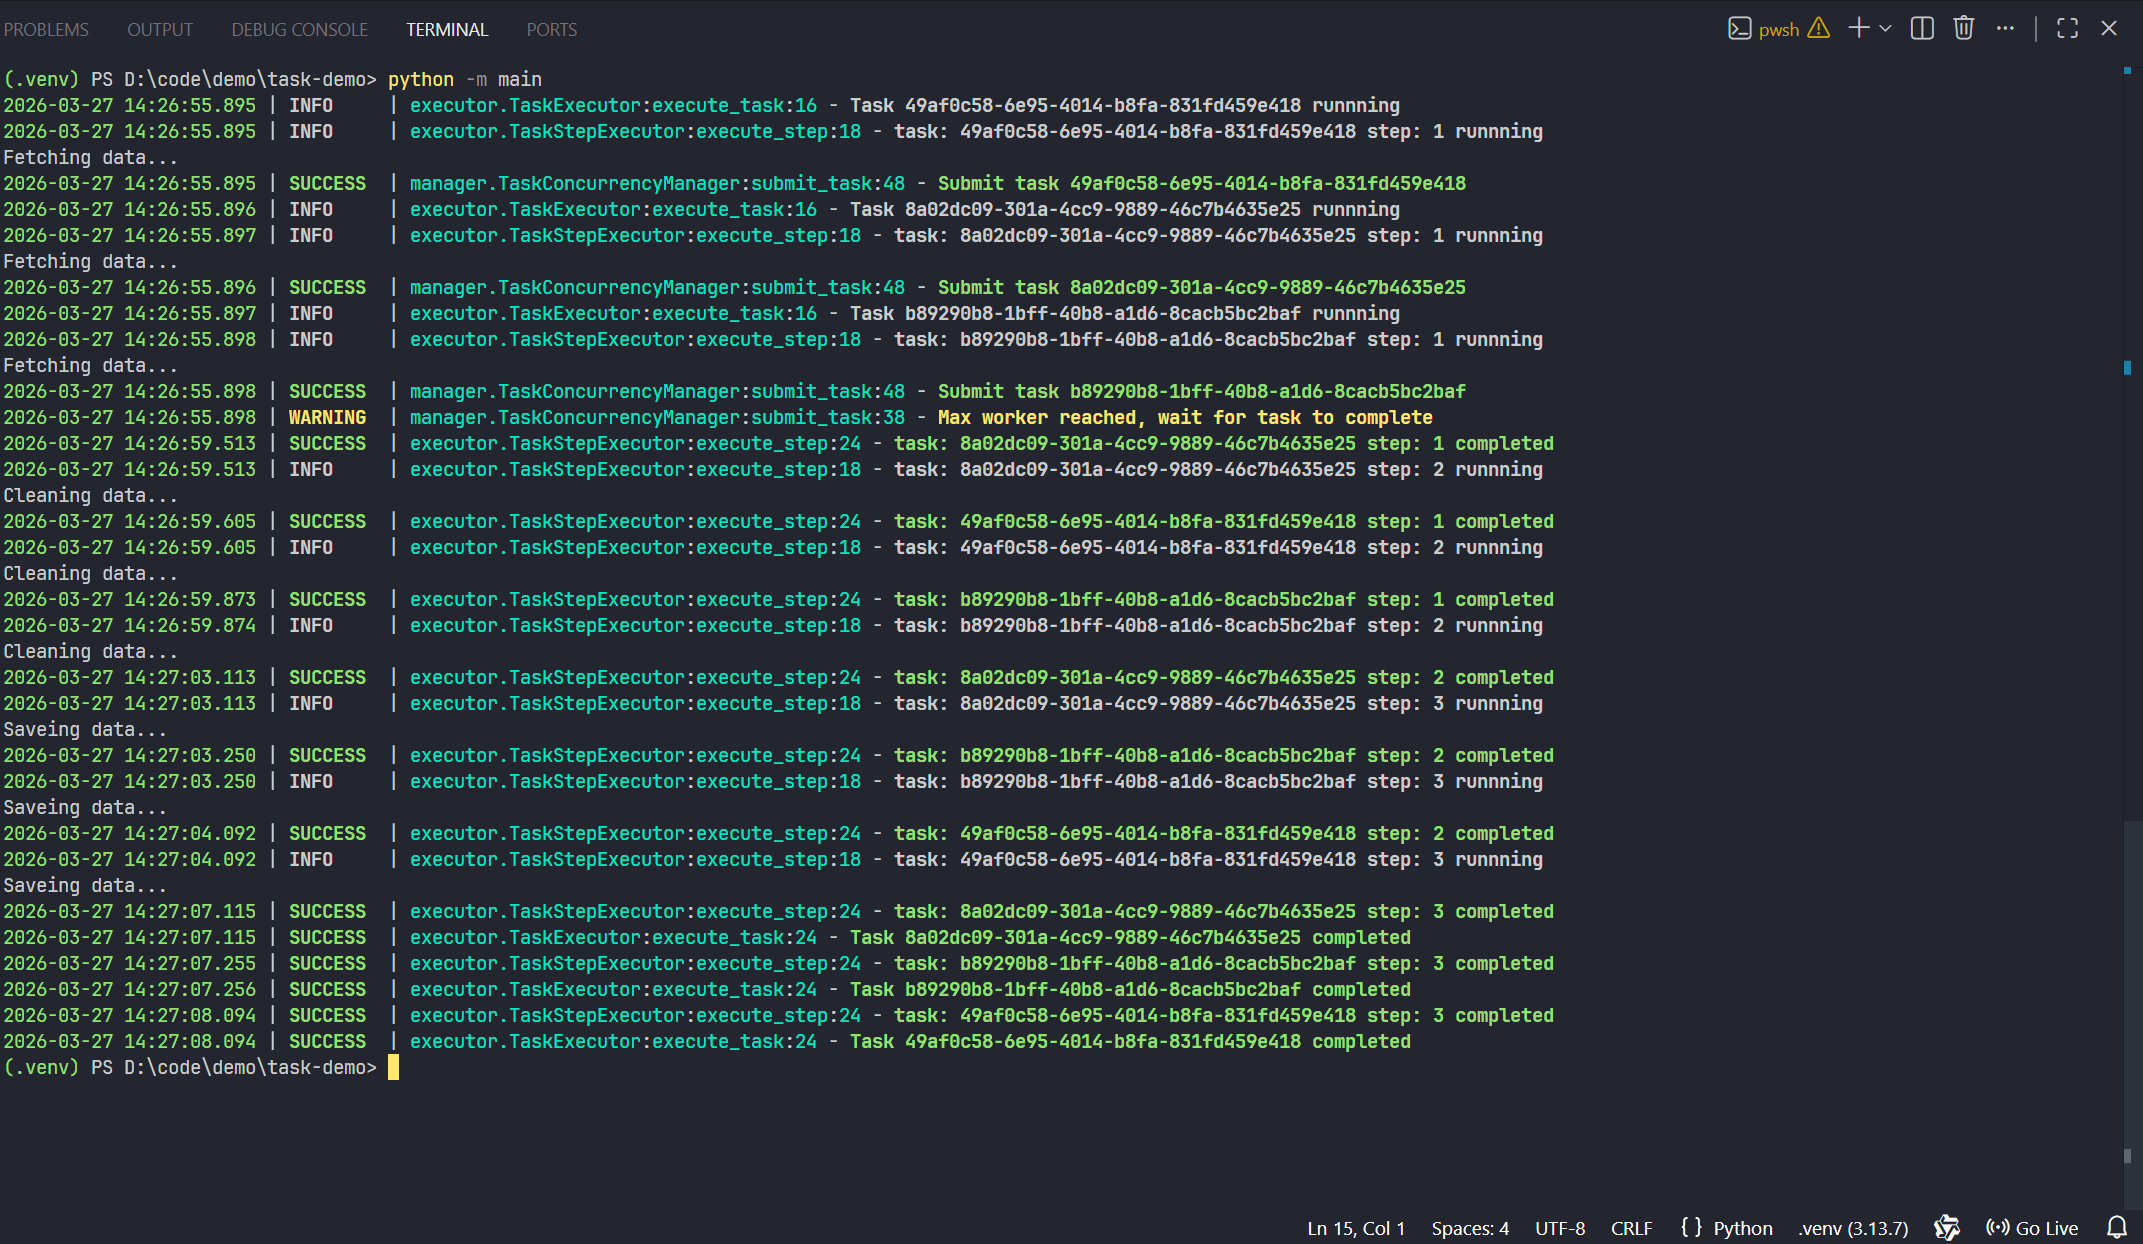
我将线程池中的线程限制到了 3 个。
3 任务执行功能点实现
3.1 暂停
接下来,就是实现暂停,继续,重新开始这几个功能点了。
首先是暂停,由于 Python 线程本身没有提供强制终止线程的方法,并且我本身也不需要强制终止,而是步骤级暂停,所以暂停的实现,思路就是在步骤完成后,判断是否传递了暂停信号,依次来判断是否暂停。
暂停信号一般都是由外部发起的,那我们怎么设计这个暂停信号呢?
其实,并不用专门设计一个暂停信号。
你想想,StepHandler 执行时,TaskStepExecutor 只会改变 TaskStep 的状态。而 Task 的状态只会被 TaskExecutor 影响,而 Task 只会在开始、出错、结束时改变,步骤执行,是不会改别的。
所以说,这个暂停信号,就可以用 Task 的状态来实现,只要在每个步骤执行完成时,判断当前 Task 的状态是不是 PAUSE 状态,那就说明是外部发起了暂停信号,那我就立刻停止任务。
from enum import Enum


class TaskStatus(str, Enum):
    PENDING = "PENDING"
    RUNNING = "RUNNING"
    WAITING = "WAITING"
    PAUSING = "PAUSING"
    PAUSED = "PAUSED"
    COMPLETED = "COMPLETED"
    FAILED = "FAILED"
新增 PAUSING 和 PAUSED 两个状态,PAUSING 作为暂停信号状态,PAUSED 作为暂停完成时的状态
修改 TaskExecutor 逻辑
from typing import Optional

from loguru import logger

from entity.Task import Task
from entity.TaskContext import TaskContext
from entity.TaskStatus import TaskStatus
from executor.TaskStepExecutor import TaskStepExecutor


class TaskExecutor:
    @staticmethod
    def execute_task(task: Task):
        try:
            task.task_status = TaskStatus.RUNNING
            logger.info(f"Task {task.task_id} runnning")

            task_context: Optional[TaskContext] = None
            for step_order in task.task_steps.keys():
                task_context = TaskStepExecutor.execute_step(
                    task, int(step_order), task_context
                )
				# 如果是暂停中状态,就退出循环
                if task.task_status == TaskStatus.PAUSING:
                    break

            logger.success(f"Task {task.task_id} completed")
            if task.task_status == TaskStatus.PAUSING:
	            # 记录暂停状态
                task.task_status = TaskStatus.PAUSED
            else:
                task.task_status = TaskStatus.COMPLETED

        except Exception as e:
            logger.error(f"Task {task.task_id} failed: {e}")

            task.task_status = TaskStatus.FAILED
            task.task_message = str(e)
3.2 继续、重新开始。
继续,其实是针对暂停的,其主要逻辑就是要判断某个步骤是否完成,完成了,就跳过。
from typing import Optional

from loguru import logger

from entity.Task import Task
from entity.TaskContext import TaskContext
from entity.TaskStatus import TaskStatus
from executor.TaskStepExecutor import TaskStepExecutor


class TaskExecutor:
    @staticmethod
    def execute_task(task: Task):
        try:
            task.task_status = TaskStatus.RUNNING
            logger.info(f"Task {task.task_id} runnning")

            task_context: Optional[TaskContext] = None
            for step_order in task.task_steps.keys():
	            # 如果是已完成状态,跳过。
                if task.task_steps[str(step_order)].step_status == TaskStatus.COMPLETED:
                    continue

                task_context = TaskStepExecutor.execute_step(
                    task, int(step_order), task_context
                )

                if task.task_status == TaskStatus.PAUSING:
                    break

            logger.success(f"Task {task.task_id} completed")
            if task.task_status == TaskStatus.PAUSING:
                task.task_status = TaskStatus.PAUSED
            else:
                task.task_status = TaskStatus.COMPLETED

        except Exception as e:
            logger.error(f"Task {task.task_id} failed: {e}")

            task.task_status = TaskStatus.FAILED
            task.task_message = str(e)
而重新开始,其实就是接收到状态后,重置所有任务和步骤的状态,然后重新开始执行。
思路就是,外部将 Task 的状态,设置为 Restarting,TaskExecutor 检查到后,将所有 TaskStep 设置为 Pending,然后完成任务的执行。
此时 TaskConcurrencyManager 的 on_task_complete 会执行,然后在这个方法新增一个逻辑,如果此时任务的状态是 Restarting,那么就重新提交任务。
from enum import Enum


class TaskStatus(str, Enum):
    PENDING = "PENDING"
    RUNNING = "RUNNING"
    WAITING = "WAITING"
    PAUSING = "PAUSING"
    PAUSED = "PAUSED"
    RESTARTING = "RESTARTING"
    COMPLETED = "COMPLETED"
    FAILED = "FAILED"
from typing import Optional

from loguru import logger

from entity.Task import Task
from entity.TaskContext import TaskContext
from entity.TaskStatus import TaskStatus
from executor.TaskStepExecutor import TaskStepExecutor


class TaskExecutor:
    @staticmethod
    def _reset_task(task: Task) -> None:
        task.task_message = ""
        for step_order in task.task_steps.keys():
            task.task_steps[str(step_order)].step_status = TaskStatus.PENDING
            task.task_steps[str(step_order)].step_message = ""

    @staticmethod
    def execute_task(task: Task):
        try:
            task.task_status = TaskStatus.RUNNING
            logger.info(f"Task {task.task_id} runnning")

            task_context: Optional[TaskContext] = None
            for step_order in task.task_steps.keys():
                if task.task_steps[str(step_order)].step_status == TaskStatus.COMPLETED:
                    continue

                task_context = TaskStepExecutor.execute_step(
                    task, int(step_order), task_context
                )
				# 检测到重启信号,结束
                if (
                    task.task_status == TaskStatus.PAUSING
                    or task.task_status == TaskStatus.RESTARTING
                ):
                    break

            logger.success(f"Task {task.task_id} completed")

            match task.task_status:
                case TaskStatus.PAUSING:
                    task.task_status = TaskStatus.PAUSED
                    logger.warning(f"Task {task.task_id} paused")
                case TaskStatus.RESTARTING:
	                # 重置步骤状态
                    TaskExecutor._reset_task(task)
                    logger.warning(f"Task {task.task_id} restarting")
                case _:
                    task.task_status = TaskStatus.COMPLETED

        except Exception as e:
            logger.error(f"Task {task.task_id} failed: {e}")

            task.task_status = TaskStatus.FAILED
            task.task_message = str(e)
from concurrent.futures import Future, ThreadPoolExecutor
from typing import Dict

from loguru import logger

from entity.Task import Task
from entity.TaskStatus import TaskStatus
from executor.TaskExecutor import TaskExecutor


class TaskConcurrencyManager:
    def __init__(self, max_worker: int = 3):
        self.executor = ThreadPoolExecutor(max_worker)
        self.running_tasks: Dict[str, Future] = {}

    def run_task(self, task: Task) -> None:
        try:
            TaskExecutor.execute_task(task)
        except Exception as e:
            logger.error(f"Run task {task.task_id} failed: {e}")
            raise

    def on_task_complete(self, task_id: str, future: Future, task: Task) -> None:
        if task_id in self.running_tasks:
            del self.running_tasks[task_id]

        try:
            future.result()
			# 如果任务状态是 RESTARTING 重置任务状态,并重新启动。
            if task.task_status == TaskStatus.RESTARTING:
                task.task_status = TaskStatus.PENDING
                self.submit_task(task)

                logger.success(f"Restart task {task.task_id} success")

        except Exception as e:
            logger.error(f"complete Task {task_id} failed: {e}")
            raise

    def submit_task(self, task: Task) -> None:
        if task.task_id in self.running_tasks:
            logger.warning(f"Task {task.task_id} is already running")
            return

        if len(self.running_tasks) >= self.executor._max_workers:
            logger.warning("Max worker reached, wait for task to complete")
            return

        future = self.executor.submit(self.run_task, task)
        self.running_tasks[task.task_id] = future

        future.add_done_callback(
            lambda future: self.on_task_complete(task.task_id, future, task)
        )

        logger.success(f"Submit task {task.task_id}")

    def pause_task(self, task: Task) -> None:
        if task.task_id not in self.running_tasks:
            logger.warning(f"Task {task.task_id} is not running")
            return

        task.task_status = TaskStatus.PAUSING

    def restart_task(self, task: Task) -> None:
        if task.task_id not in self.running_tasks:
            logger.warning(f"Task {task.task_id} is not running")
            return

        task.task_status = TaskStatus.RESTARTING
我将暂停和重启的方法也一并写入了。
修改一下 main 文件,测试一下。
import time

from manager.TaskConcurrencyManager import TaskConcurrencyManager
from pipeline.TaskMainPipeline import TaskMainPipeline


def run() -> None:
    task_concurrency_manager = TaskConcurrencyManager(max_worker=4)

    pause_task = None
    restartning_task = None

    for i in range(4):
        task = TaskMainPipeline.build_main_pipeline()
        task_concurrency_manager.submit_task(task=task)

        if i == 2:
            pause_task = task

        if i == 3:
            restartning_task = task

    time.sleep(5)
    if pause_task:
        task_concurrency_manager.pause_task(pause_task)
    time.sleep(1)
    if restartning_task:
        task_concurrency_manager.restart_task(restartning_task)

    # 等待任务运行完成
    time.sleep(20)


if __name__ == "__main__":
    run()
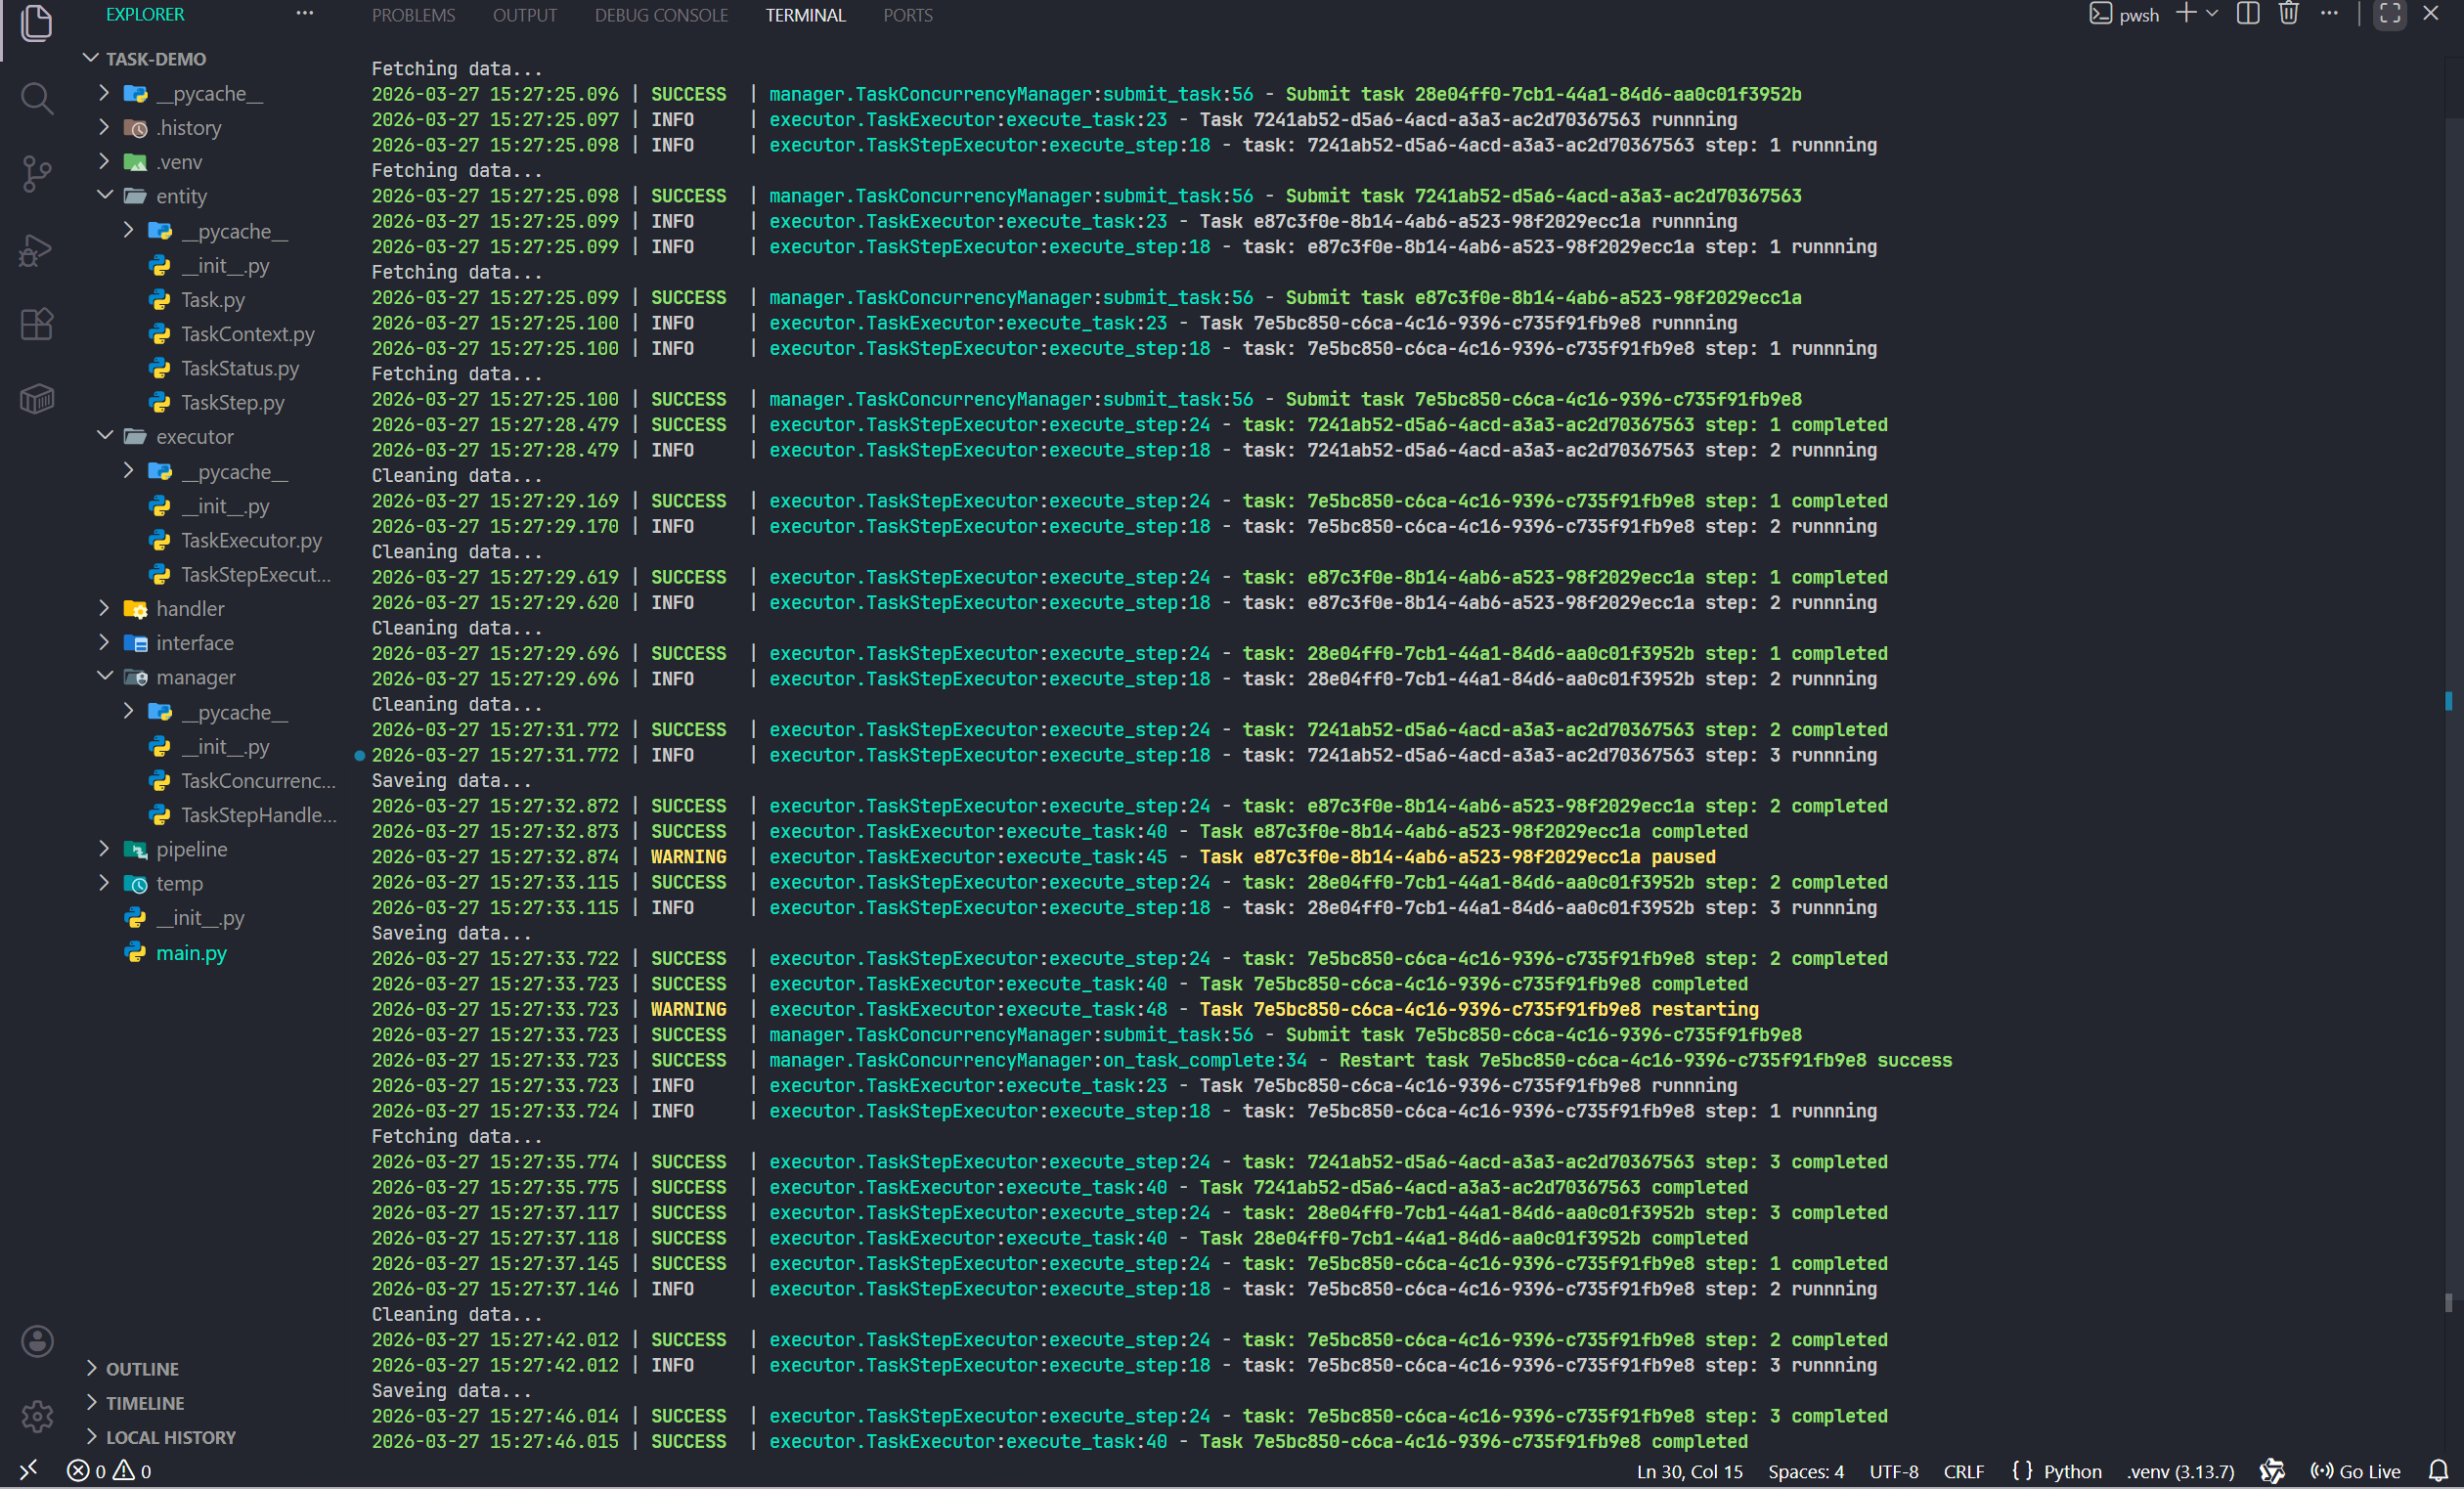
3.3 等待
差点忘了,还有个排队等待的功能没实现。
这个功能如果往简单来做,只要在 submit_task 方法,判断当前的 runnning_tasks 是否达到 5 个了,如果是,就睡眠等待,直到有任务完成,有位置了,再启动;否则就一直循环睡眠。
但是这个方法有个弊端,如果我的线程池大小是 3 ,但是我启动了 100 个任务呢?此时就有 97 个任务占着资源,一直睡眠等待,十分浪费资源。
我绝对一个比较好的思路是,将 Task 的状态持久化到数据库,或者文件,当线程池没有线程了,就将多余的任务的状态,设置为 Waiting,存入数据库或者文件。
外部再额外维护一个轮询任务,定期检测 runnning_tasks 的数量,如果小于 5 ,就从数据库或者文件读取最早插入的 Waiting 任务,启动它。
这样,如果启动的任务数大大超出了线程池大小,就不会出现大量任务线程占着资源的情况。
由于这个涉及到数据持久化,需要增加的功能略多,我暂时没有时间实现这个机制。因为目前我的任务量不算大,用当前的逻辑绰绰有余。
我后续有时间了,再继续实现这个吧。
0 人赞过
评论
评论加载中…